
Python을 사용하여 프레젠테이션에서 오디오 관리
개요
이 문서에서는 Aspose.Slides에서 오디오 프레임을 사용하는 방법을 설명합니다. 슬라이드에 임베드된 오디오를 추가하고, 오디오 프레임 섬네일을 사용자 지정하며, 볼륨, 반복, 숨기기, 트리밍 및 페이드 지속시간과 같은 재생 옵션을 구성하고, 슬라이드 쇼 전환에 사용되는 오디오를 추출하는 방법을 보여줍니다.
오디오 프레임 만들기
Aspose.Slides for Python via Java를 사용하면 오디오 파일을 슬라이드에 추가할 수 있습니다. 오디오 파일은 오디오 프레임으로 슬라이드에 임베드됩니다.
- Presentation 클래스의 인스턴스를 생성합니다.
- 인덱스로 슬라이드에 대한 참조를 가져옵니다.
- 슬라이드에 임베드할 오디오 파일을 읽습니다.
- 임베드된 오디오 프레임(오디오 파일을 포함)을 슬라이드에 추가합니다.
- AudioFrame 객체가 제공하는 setPlayMode 및 setVolume 메서드를 사용합니다.
- 수정된 프레젠테이션을 저장합니다.
다음 Python 코드는 슬라이드에 임베드된 오디오 프레임을 추가하는 방법을 보여줍니다:
from pathlib import Path

import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import AudioPlayModePreset, AudioVolumeMode, Presentation, SaveFormat

presentation = Presentation()
try:
    slide = presentation.getSlides().get_Item(0)
    audio_data = Path("audio.wav").read_bytes()
    java_audio_data = jpype.JArray(jpype.JByte)(audio_data)
    audio = presentation.getAudios().addAudio(java_audio_data)
    audio_frame = slide.getShapes().addAudioFrameEmbedded(50, 150, 100, 100, audio)

    audio_frame.setPlayMode(AudioPlayModePreset.Auto)
    audio_frame.setVolume(AudioVolumeMode.Loud)
    presentation.save("AudioFrameEmbed_out.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
오디오 프레임 섬네일 변경
프레젠테이션에 오디오 파일을 추가하면 오디오는 표준 기본 이미지가 표시된 프레임으로 나타납니다(아래 섹션의 이미지를 참조). 오디오 프레임의 미리보기 이미지를 원하는 이미지로 변경할 수 있습니다.
다음 Python 코드는 오디오 프레임의 섬네일 또는 미리보기 이미지를 변경하는 방법을 보여줍니다:
from pathlib import Path

import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Images, Presentation, SaveFormat

presentation = Presentation()
try:
    slide = presentation.getSlides().get_Item(0)
    audio_data = Path("sample2.mp3").read_bytes()
    java_audio_data = jpype.JArray(jpype.JByte)(audio_data)
    audio = presentation.getAudios().addAudio(java_audio_data)
    audio_frame = slide.getShapes().addAudioFrameEmbedded(150, 100, 50, 50, audio)

    image = Images.fromFile("eagle.jpeg")
    try:
        picture = presentation.getImages().addImage(image)
    finally:
        image.dispose()

    audio_frame.getPictureFormat().getPicture().setImage(picture)
    presentation.save("example_out.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
오디오 재생 옵션 변경
Aspose.Slides for Python via Java를 사용하면 오디오 재생 또는 속성을 제어하는 옵션을 변경할 수 있습니다. 예를 들어 오디오 볼륨을 조절하고, 오디오를 반복 재생하도록 설정하거나, 오디오 아이콘을 숨길 수 있습니다.
Microsoft PowerPoint의 Audio Options 창:
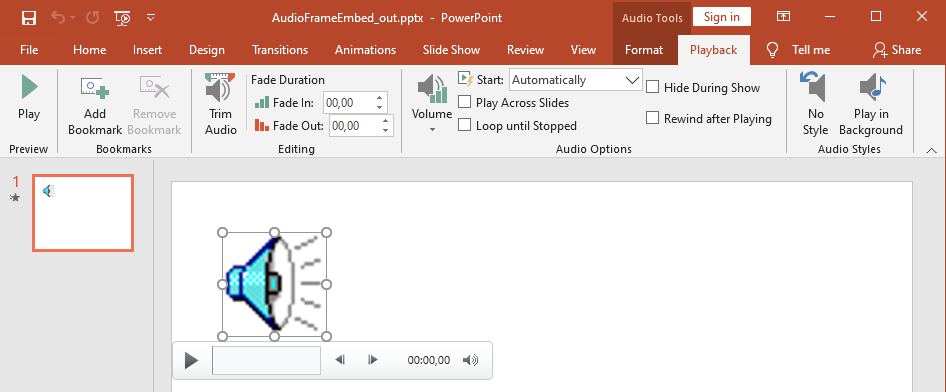
PowerPoint Audio Options는 Aspose.Slides AudioFrame 속성과 다음과 같이 일치합니다:
- Start 드롭다운 목록은 setPlayMode 메서드와 일치합니다
- Volume은 setVolume 메서드와 일치합니다
- Play Across Slides는 setPlayAcrossSlides 메서드와 일치합니다
- Loop until Stopped는 setPlayLoopMode 메서드와 일치합니다
- Hide During Show는 setHideAtShowing 메서드와 일치합니다
- Rewind after Playing는 setRewindAudio 메서드와 일치합니다
PowerPoint Editing 옵션은 Aspose.Slides AudioFrame 속성과 다음과 같이 일치합니다:
- Fade In은 setFadeInDuration 메서드와 일치합니다
- Fade Out은 setFadeOutDuration 메서드와 일치합니다
- Trim Audio Start Time은 setTrimFromStart 메서드와 일치합니다
- Trim Audio End Time 값은 오디오 전체 길이에서 setTrimFromEnd 메서드로 설정된 값을 뺀 값과 같습니다
오디오 제어 패널의 PowerPoint Volume control은 setVolumeValue 메서드에 해당합니다. 이 메서드를 사용하면 오디오 볼륨을 백분율로 변경할 수 있습니다.
오디오 재생 옵션을 변경하는 방법은 다음과 같습니다:
- Create 또는 오디오 프레임을 가져옵니다.
- 조정하려는 오디오 프레임 속성의 새 값을 설정합니다.
- 수정된 PowerPoint 파일을 저장합니다.
다음 Python 코드는 오디오 옵션을 조정하는 작업을 보여줍니다:
import jpile
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import AudioFrame, AudioPlayModePreset, AudioVolumeMode, Presentation, SaveFormat

presentation = Presentation("AudioFrameEmbed_out.pptx")
try:
    audio_frame = presentation.getSlides().get_Item(0).getShapes().get_Item(0)
    if isinstance(audio_frame, AudioFrame):
        # 클릭 시 재생, 낮은 볼륨, 슬라이드 전반에 걸쳐, 반복 없이.
        audio_frame.setPlayMode(AudioPlayModePreset.OnClick)
        audio_frame.setVolume(AudioVolumeMode.Low)
        audio_frame.setPlayAcrossSlides(True)
        audio_frame.setPlayLoopMode(False)
        # 슬라이드 쇼 중에 프레임을 숨기고 재생 후 되감기.
        audio_frame.setHideAtShowing(True)
        audio_frame.setRewindAudio(True)
        presentation.save("AudioFrameEmbed_changed.pptx", SaveFormat.Pptx)
    else:
        print("The shape is not an audio frame.")
finally:
    presentation.dispose()
다음 Python 예제는 임베드된 오디오가 포함된 새 오디오 프레임을 추가하고, 트리밍하고, 페이드 지속시간을 설정하는 방법을 보여줍니다:
from pathlib import Path

import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat

presentation = Presentation()
try:
    slide = presentation.getSlides().get_Item(0)
    audio_data = Path("sampleaudio.mp3").read_bytes()
    java_audio_data = jpype.JArray(jpype.JByte)(audio_data)
    audio = presentation.getAudios().addAudio(java_audio_data)
    audio_frame = slide.getShapes().addAudioFrameEmbedded(50, 50, 100, 100, audio)

    # 시작부터 1.5초, 끝에서 2초를 잘라냅니다.
    audio_frame.setTrimFromStart(1500.0)
    audio_frame.setTrimFromEnd(2000.0)
    # 페이드인 시간을 200 ms, 페이드아웃 시간을 500 ms로 설정합니다.
    audio_frame.setFadeInDuration(200.0)
    audio_frame.setFadeOutDuration(500.0)
    presentation.save("AudioFrameTrimFade_out.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
다음 코드 샘플은 임베드된 오디오가 있는 오디오 프레임을 검색하고 볼륨을 85%로 설정하는 방법을 보여줍니다:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import AudioFrame, Presentation, SaveFormat

presentation = Presentation("AudioFrameEmbed_out.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    audio_frame = slide.getShapes().get_Item(0)
    if isinstance(audio_frame, AudioFrame):
        audio_frame.setVolumeValue(85.0)
        presentation.save("AudioFrameValue_out.pptx", SaveFormat.Pptx)
    else:
        print("The shape is not an audio frame.")
finally:
    presentation.dispose()
오디오 캡션 관리
Aspose.Slides를 사용하면 getCaptionTracks 메서드를 통해 오디오 프레임에 폐쇄 캡션을 추가할 수 있습니다. 이 메서드는 CaptionsCollection을 반환하며, 이를 사용해 WebVTT 캡션 트랙을 추가하고, 기존 트랙을 순회하며, 필요에 따라 제거할 수 있습니다.
Add Audio Captions
getCaptionTracks 메서드를 사용해 오디오 프레임에 하나 이상 캡션 트랙을 연결합니다. 아래 예제에서는 오디오 파일을 슬라이드에 추가한 후, .vtt 파일에서 새 캡션 트랙을 로드합니다.
from pathlib import Path

import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat

presentation = Presentation()
try:
    audio_data = Path("audio.mp3").read_bytes()
    java_audio_data = jpype.JArray(jpype.JByte)(audio_data)
    audio = presentation.getAudios().addAudio(java_audio_data)
    slide = presentation.getSlides().get_Item(0)
    audio_frame = slide.getShapes().addAudioFrameEmbedded(10, 10, 50, 50, audio)

    # WebVTT 파일에서 새 캡션 트랙을 추가합니다.
    audio_frame.getCaptionTracks().add("New track", "track.vtt")
    presentation.save("audio_with_captions.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Extract Audio Captions
오디오 프레임에 연결된 캡션 트랙을 순회하면서 .vtt 파일로 저장할 수 있습니다. 각 캡션 트랙은 바이너리 데이터와 고유 식별자를 제공하므로 캡션을 내보낼 때 사용할 수 있습니다.
from pathlib import Path

import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import AudioFrame, Presentation

presentation = Presentation("audio_with_captions.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    for shape in slide.getShapes():
        if isinstance(shape, AudioFrame):
            for caption_track in shape.getCaptionTracks():
                # 캡션 트랙을 .vtt 파일로 저장합니다.
                file_path = Path(str(caption_track.getCaptionId()) + ".vtt")
                caption_data = bytes(caption_track.getBinaryData())
                file_path.write_bytes(caption_data)
finally:
    presentation.dispose()
Remove Audio Captions
오디오 프레임에서 캡션을 제거하려면 CaptionsCollection에서 제공하는 clear, remove 또는 removeAt 메서드를 사용합니다. 다음 예제는 오디오 프레임의 모든 캡션 트랙을 제거합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import AudioFrame, Presentation, SaveFormat

presentation = Presentation("audio_with_captions.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    audio_frame = slide.getShapes().get_Item(0)
    if isinstance(audio_frame, AudioFrame):
        audio_frame.getCaptionTracks().clear()
        presentation.save("audio_without_captions.pptx", SaveFormat.Pptx)
    else:
        print("The shape is not an audio frame.")
finally:
    presentation.dispose()
오디오 추출
Aspose.Slides for Python via Java를 사용하면 슬라이드 쇼 전환에 사용된 사운드를 추출할 수 있습니다. 예를 들어 특정 슬라이드에서 사용된 사운드를 추출할 수 있습니다.
- 오디오가 포함된 프레젠테이션을 로드하기 위해 Presentation 클래스의 인스턴스를 생성합니다.
- 인덱스로 해당 슬라이드에 대한 참조를 가져옵니다.
- 슬라이드에 대한 slideshow transitions를 가져옵니다.
- 사운드를 바이트 데이터로 추출합니다.
다음 Python 코드는 슬라이드에 사용된 오디오를 추출하는 방법을 보여줍니다:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation

presentation = Presentation("AudioSlide.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    transition = slide.getSlideShowTransition()
    sound = transition.getSound()
    if sound is not None:
        audio_data = sound.getBinaryData()
        print("Length:", len(audio_data))
    else:
        print("The slide transition has no sound.")
finally:
    presentation.dispose()
FAQ
같은 오디오 자산을 여러 슬라이드에서 재사용하면서 파일 크기가 증가하지 않나요?
예. 오디오를 프레젠테이션의 공유 audio collection에 한 번 추가하고, 해당 자산을 참조하는 추가 오디오 프레임을 생성하면 됩니다. 이렇게 하면 미디어 데이터가 중복되지 않아 프레젠테이션 크기가 관리됩니다.
기존 오디오 프레임의 사운드를 형상을 다시 만들지 않고 교체할 수 있나요?
예. 연결된 사운드인 경우 link path를 새 파일을 가리키도록 업데이트합니다. 임베드된 사운드인 경우 프레젠테이션의 audio collection에서 다른 embedded audio 객체로 교체합니다. 프레임의 서식과 대부분의 재생 설정은 그대로 유지됩니다.
트리밍이 프레젠테이션에 저장된 원본 오디오 데이터를 변경하나요?
아니오. 트리밍은 재생 구간만 조정합니다. 원본 오디오 바이트는 그대로 유지되며, 임베드된 오디오나 프레젠테이션의 오디오 컬렉션을 통해 접근할 수 있습니다.