
Sök och ersätt text i PowerPoint-presentationer i Python via Java
Översikt
Aspose.Slides för Python via Java kan söka, markera och ersätta text i en enskild textram eller i hela en presentation. Varje operation kan också meddela en applikation om varje matchning via ett resultat‑callback. Detta gör det möjligt att uppdatera en presentation och samtidigt bygga ett revisionsspår som innehåller den matchade texten, dess sammanhang, position, textram och bildnummer.
Dessa funktioner är användbara för granskning, maskning, terminologikontroller, mallrengöring och automatiserade rapporteringsarbetsflöden.
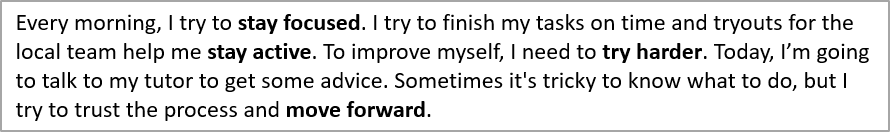
I de första exemplen nedan använder vi en fil namngiven “sample.pptx”, som innehåller en enda textruta på den första bilden med följande text:
Välj sökområde
Använd metoder på TextFrame för att begränsa en operation till ett textram. Använd metoder på Presentation för att bearbeta all tillämplig text i presentationen.
| Operation | Ett textram | Hela presentationen |
|---|---|---|
| Markera bokstavlig text | TextFrame.highlightText | Presentation.highlightText |
| Markera reguljära uttrycks‑matchningar | TextFrame.highlightRegex | Presentation.highlightRegex |
| Ersätt bokstavlig text | TextFrame.replaceText | Presentation.replaceText |
| Ersätt reguljära uttrycks‑matchningar | TextFrame.replaceRegex | Presentation.replaceRegex |
Konfigurera textmatchning
För bokstavliga textoperationer, använd TextSearchOptions för att styra matchning:
- setWholeWordsOnly begränsar matchningar till hela ord.
- setCaseSensitive styr om teckenens skiftläge måste matcha.
- setIncludeNotes inkluderar bildanteckningar i sök-, ersättnings- och markeringsoperationer på presentationsnivå.
Reguljära uttrycks‑operationer använder ett Java Pattern, så matchningsregler såsom skiftlägeskänslighet och ordgränser definieras av uttrycket och dess flaggor.
Identifiera ägaren till ett textram
Generiska textbehandlingsarbetsflöden får ofta ett TextFrame när de söker, ersätter, validerar eller exporterar text. Använd TextFrame.getParentShape och TextFrame.getParentCell för att avgöra vilket presentationsobjekt som äger textramet.
De förväntade värdena beror på ägaren:
| Ägare av textram | getParentShape |
getParentCell |
|---|---|---|
| En AutoShape eller en annan textinnehållande form | Den ägande Shape | None |
| En tabellcell | None |
Den ägande Cell |
Båda metoderna ger skrivskyddad navigation. Att anropa dem flyttar inte textramet eller ändrar dess ägare. Generisk kod bör kontrollera båda värdena för None och hantera möjligheten att ingen ägare är tillgänglig.
Följande exempel använder SlideUtil.getAllTextFrames för att iterera genom textramen i en presentation. För former rapporterar den formens namn, Java‑körtidstyp och innehållande bild. För tabellceller rapporterar den nollbaserade kolumn‑ och radkoordinater samt den innehållande bilden.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
För SmartArt-innehåll, iterera genom formerna i SmartArtNode.getShapes och hämta varje SmartArtShape.getTextFrame. Textramet kan spåras till sin associerade form via TextFrame.getParentShape, medan TextFrame.getParentCell returnerar None. Därför hanterar formgrenen i exemplet också text från SmartArt‑noder.
Samla matchningsinformation med ett callback
Implementera IFindResultCallback via jpype.JProxy för att ta emot en notifikation för varje matchning. Dess foundResult‑metod tillhandahåller det relaterade textramet, källtexten, den matchade texten och matchningspositionen.
Callbacken får inte ett bildnummer direkt. Implementeringen nedan härleder det från föräldrabilden och hanterar även text som hittas i bildanteckningar. Ett valfritt bildnummer möjliggör att samma resultatsmodell kan representera text som är knuten till andra bildtyper.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
För ersättningsoperationer innehåller found_text den ursprungliga matchade texten, så callbacken kan exakt registrera vilka termer som ersattes.
Markera text
Använd metoden TextFrame.highlightText för att markera bokstavliga textmatchningar i ett textram. Skicka TextSearchOptions för att styra sökningen och ett callback för att samla in matchningsdetaljer.
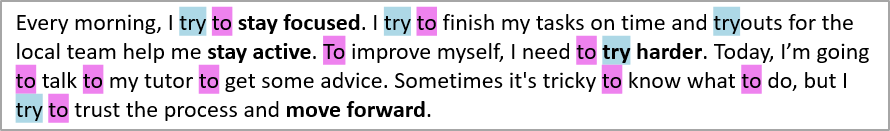
Kodexemplet nedan markerar alla förekomster av tecknen “try” och markerar sedan endast hela ordet “to”. Båda sökningarna rapporterar sina matchningar till samma callback.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpage.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Markera varje förekomst av "try" i textramen.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Markera endast det kompletta ordet "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Resultatet:
Markera text med reguljära uttryck
Metoden TextFrame.highlightRegex markerar textmatchningar som hittas med ett reguljärt uttryck i ett textram.
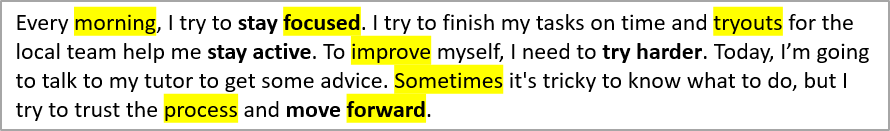
Följande kod markerar alla ord som innehåller sju eller fler tecken och samlar varje matchning:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Resultatet:
Markera text i en presentation
Använd Presentation.highlightText och Presentation.highlightRegex för att söka alla tillämpliga textramar i en presentation. Följande exempel markerar ett bokstavligt begrepp och alla e‑postadresser samtidigt som separata resultatsamlingar hålls för de två sökningarna.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Ersätt text i ett textram
Använd TextFrame.replaceText för bokstavlig text och TextFrame.replaceRegex för mönsterbaserad ersättning. Dessa metoder uppdaterar den matchade texten inom det befintliga textramet, vilket behåller formateringen i de omgivande delarna i stället för att återskapa textramet från en ren sträng.
Följande exempel standardiserar en stavningsvariant och ersätter sedan versionsetiketter. Samma callback registrerar de ursprungliga termerna som matchades av båda operationerna.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Om en matchning sträcker sig över delar med olika formatering, granska resultatet för att bekräfta vilken formatering som ska tillämpas på den ersatta texten.
Ersätt text i en presentation
Använd Presentation.replaceText och Presentation.replaceRegex för att tillämpa samma operationer i hela presentationen. Detta är användbart för mallrengöring, terminologiuppdateringar och maskning.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Gruppera matchningar för rapportering
Eftersom varje resultat lagrar sitt bildnummer och textram kan applikationer gruppera matchningar för revision, rapportering eller granskningsarbetsflöden. Följande exempel grupperar de insamlade resultaten först efter bild och sedan efter textram:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
Hur kan jag söka i endast en textruta istället för hela presentationen?
Hämta figurens textram och anropa TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText eller TextFrame.replaceRegex på det textramet. Metoder på presentationsnivå bearbetar alla tillämpliga textramar istället.
Hur kan jag matcha hela ord med korrekt versalning?
Ställ in TextSearchOptions.setWholeWordsOnly och TextSearchOptions.setCaseSensitive till True och skicka alternativen till en bokstavlig textmarkerings‑ eller ersättningsmetod. För reguljära uttryck definieras ordgränser och skiftlägeskänslighet i själva Java Pattern.
Kan sökning och ersättning inkludera text i bildanteckningar?
Ja. Ställ in TextSearchOptions.setIncludeNotes till True när du använder en bokstavlig textoperation på presentationsnivå. Callback‑implementeringen ovan mappar en matchning i en anteckningsbild tillbaka till dess föräldrabildnummer.
Hur kan jag skapa en rapport utan att skanna presentationen en andra gång?
Skicka en IFindResultCallback‑implementation till markerings‑ eller ersättningsoperationen. Callbacken får varje matchning medan operationen körs, så applikationen kan lagra källtexten, den matchade texten, positionen, textramet och härledda bildnumret för senare gruppering eller export.
Behåller ersättning av text dess formatering?
TextFrame.replaceText och TextFrame.replaceRegex ändrar den matchade texten inom det befintliga textramet och behåller formateringen i de omgivande delarna. Om en matchning sträcker sig över delar med olika formatering, inspektera resultatet för att säkerställa att ersättningen använder önskad stil.