
Cerca e sostituisci testo in presentazioni PowerPoint in Python tramite Java
Panoramica
Aspose.Slides per Python tramite Java può cercare, evidenziare e sostituire il testo in un singolo riquadro di testo o in tutta la presentazione. Ogni operazione può anche notificare un’applicazione su ogni corrispondenza tramite un callback di risultato. Ciò consente di aggiornare una presentazione e allo stesso tempo generare una traccia di audit contenente il testo corrispondente, il suo contesto, la posizione, il riquadro di testo e il numero della diapositiva.
Queste funzionalità sono utili per revisioni, redazioni, controlli di terminologia, pulizia di modelli e flussi di lavoro di reporting automatico.
Nei primi esempi seguenti, utilizziamo un file chiamato “sample.pptx”, che contiene un singolo riquadro di testo nella prima diapositiva con il seguente contenuto:
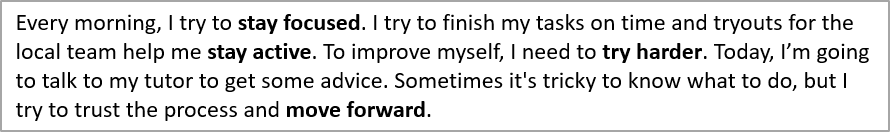
Scegliere l’ambito di ricerca
Utilizzare i metodi su TextFrame per limitare un’operazione a un singolo riquadro di testo. Utilizzare i metodi su Presentation per elaborare tutto il testo applicabile nella presentazione.
| Operazione | Un riquadro di testo | Intera presentazione |
|---|---|---|
| Evidenzia testo letterale | TextFrame.highlightText | Presentation.highlightText |
| Evidenzia corrispondenze di espressioni regolari | TextFrame.highlightRegex | Presentation.highlightRegex |
| Sostituisci testo letterale | TextFrame.replaceText | Presentation.replaceText |
| Sostituisci corrispondenze di espressioni regolari | TextFrame.replaceRegex | Presentation.replaceRegex |
Configurare la corrispondenza del testo
Per le operazioni su testo letterale, utilizzare TextSearchOptions per controllare la corrispondenza:
- setWholeWordsOnly limita le corrispondenze a parole intere.
- setCaseSensitive controlla se il caso dei caratteri deve corrispondere.
- setIncludeNotes include le note della diapositiva nelle operazioni di ricerca, sostituzione e evidenziazione a livello di presentazione.
Le operazioni con espressioni regolari utilizzano un Pattern Java, quindi le regole di corrispondenza come la sensibilità al maiuscolo/minuscolo e i confini di parola sono definite dall’espressione e dalle sue opzioni.
Identificare il proprietario di un riquadro di testo
I flussi di lavoro generici di elaborazione del testo spesso ricevono un TextFrame durante la ricerca, la sostituzione, la validazione o l’esportazione del testo. Utilizzare TextFrame.getParentShape e TextFrame.getParentCell per determinare quale oggetto della presentazione possiede il riquadro di testo.
| Proprietario del riquadro di testo | getParentShape |
getParentCell |
|---|---|---|
| Un AutoShape o un’altra forma contenente testo | La Shape proprietaria | None |
| Una cella di tabella | None |
La Cell proprietaria |
Entrambi i metodi forniscono una navigazione in sola lettura. Chiamarli non sposta il riquadro di testo né ne cambia il proprietario. Il codice generico dovrebbe controllare entrambi i valori per None e gestire la possibilità che nessuno dei due proprietari sia disponibile.
Il seguente esempio utilizza SlideUtil.getAllTextFrames per iterare attraverso i riquadri di testo in una presentazione. Per le forme, riporta il nome della forma, il tipo di runtime Java e la diapositiva contenente. Per le celle di tabella, riporta le coordinate di colonna e riga basate su zero e la diapositiva contenente.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Per i contenuti SmartArt, iterare attraverso le forme in SmartArtNode.getShapes e accedere a ciascuna SmartArtShape.getTextFrame. Il riquadro di testo può essere ricondotto alla forma associata tramite TextFrame.getParentShape, mentre TextFrame.getParentCell restituisce None. Pertanto, il ramo delle forme nell’esempio gestisce anche il testo proveniente da nodi SmartArt.
Raccogliere informazioni sulla corrispondenza con un callback
Implementare IFindResultCallback tramite jpype.JProxy per ricevere una notifica per ogni corrispondenza. Il suo metodo foundResult fornisce il riquadro di testo correlato, il testo sorgente, il testo corrispondente e la posizione della corrispondenza.
Il callback non riceve direttamente un numero di diapositiva. L’implementazione mostrata di seguito lo ricava dalla diapositiva padre e gestisce anche il testo trovato nelle note della diapositiva. Un numero di diapositiva opzionale consente allo stesso modello di risultato di rappresentare testo associato ad altri tipi di diapositiva.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Per le operazioni di sostituzione, found_text contiene il testo originale corrispondente, così il callback può registrare esattamente quali termini sono stati sostituiti.
Evidenziare il testo
Utilizzare il metodo TextFrame.highlightText per evidenziare le corrispondenze di testo letterale in un riquadro di testo. Passare TextSearchOptions per controllare la ricerca e un callback per raccogliere i dettagli della corrispondenza.
Il codice di esempio sottostante evidenzia tutte le occorrenze dei caratteri “try” e poi evidenzia solo la parola intera “to”. Entrambe le ricerche riportano le loro corrispondenze allo stesso callback.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Evidenzia ogni occorrenza di "try" nel riquadro di testo.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Evidenzia solo la parola intera "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Il risultato:
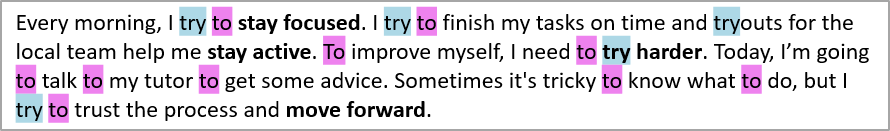
Evidenziare il testo usando le espressioni regolari
Il metodo TextFrame.highlightRegex evidenzia le corrispondenze di testo trovate da un’espressione regolare in un riquadro di testo.
Il codice seguente evidenzia tutte le parole contenenti sette o più caratteri e raccoglie ogni corrispondenza:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Il risultato:
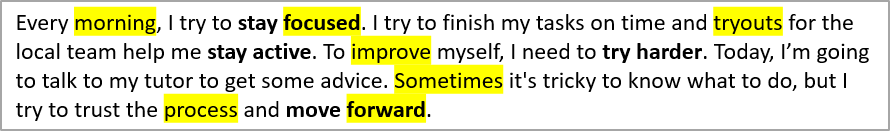
Evidenziare il testo in tutta la presentazione
Utilizzare Presentation.highlightText e Presentation.highlightRegex per cercare tutti i riquadri di testo applicabili in una presentazione. Il seguente esempio evidenzia un termine letterale e tutti gli indirizzi email mantenendo collezioni di risultati separate per le due ricerche.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Sostituire il testo in un riquadro di testo
Utilizzare TextFrame.replaceText per testo letterale e TextFrame.replaceRegex per sostituzione basata su modello. Questi metodi aggiornano il testo corrispondente all’interno del riquadro di testo esistente, mantenendo la formattazione della porzione circostante anziché ricostruire il riquadro di testo da una stringa semplice.
Il seguente esempio standardizza una variante ortografica e poi sostituisce le etichette di versione. Lo stesso callback registra i termini originali corrispondenti a entrambe le operazioni.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Se una corrispondenza si estende su parti con formattazione diversa, controllare l’output per confermare quale formattazione deve essere applicata al testo sostituito.
Sostituire il testo in tutta la presentazione
Utilizzare Presentation.replaceText e Presentation.replaceRegex per applicare le stesse operazioni all’intera presentazione. Questo è utile per la pulizia di modelli, aggiornamenti di terminologia e redazione.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Raggruppare le corrispondenze per il reporting
Poiché ogni risultato memorizza il suo numero di diapositiva e il riquadro di testo, le applicazioni possono raggruppare le corrispondenze per audit, reporting o flussi di lavoro di revisione. Il seguente esempio raggruppa i risultati raccolti prima per diapositiva e poi per riquadro di testo:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
Come posso cercare solo una casella di testo invece dell’intera presentazione?
Ottieni il riquadro di testo della forma e chiama TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText o TextFrame.replaceRegex su quel riquadro di testo. I metodi a livello di presentazione elaborano tutti i riquadri di testo applicabili invece.
Come posso far corrispondere parole intere con la corretta capitalizzazione?
Imposta TextSearchOptions.setWholeWordsOnly e TextSearchOptions.setCaseSensitive su True, e passa le opzioni a un metodo di evidenziazione o sostituzione di testo letterale. Per le espressioni regolari, definisci i confini di parola e la sensibilità al caso direttamente nel Pattern Java.
La ricerca e la sostituzione possono includere il testo nelle note della diapositiva?
Sì. Imposta TextSearchOptions.setIncludeNotes su True quando utilizzi un’operazione di testo letterale a livello di presentazione. L’implementazione del callback mostrata sopra mappa una corrispondenza in una diapositiva di note al numero della diapositiva padre.
Come posso creare un report senza scansionare nuovamente la presentazione?
Passa un’implementazione di IFindResultCallback all’operazione di evidenziazione o sostituzione. Il callback riceve ogni corrispondenza durante l’esecuzione dell’operazione, così l’applicazione può memorizzare il testo sorgente, il testo corrispondente, la posizione, il riquadro di testo e il numero di diapositiva derivato per successivi raggruppamenti o esportazioni.
La sostituzione del testo mantiene la formattazione?
TextFrame.replaceText e TextFrame.replaceRegex modificano il testo corrispondente all’interno del riquadro di testo esistente e mantengono la formattazione della porzione circostante. Se una corrispondenza si estende su parti con formattazione diversa, ispeziona il risultato per assicurarti che la sostituzione utilizzi lo stile desiderato.