
Zoeken en vervangen van tekst in PowerPoint-presentaties in Python via Java
Overzicht
Aspose.Slides for Python via Java kan tekst zoeken, markeren en vervangen in een afzonderlijk tekstframe of in de gehele presentatie. Elke bewerking kan bovendien een applicatie op de hoogte stellen van elke overeenkomst via een resultaatcallback. Hierdoor is het mogelijk om een presentatie bij te werken en tegelijk een auditlog op te bouwen met de gevonden tekst, de context, positie, het tekstframe en het dia‑nummer.
Deze mogelijkheden zijn nuttig voor review, redactie, terminologiecontroles, schoonmaken van sjablonen en geautomatiseerde rapportage‑workflows.
In de eerste voorbeelden hieronder gebruiken we een bestand met de naam “sample.pptx”, dat een enkel tekstvak op de eerste dia bevat met de volgende tekst:
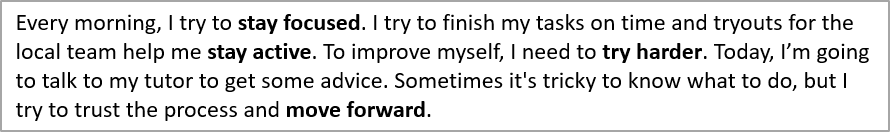
Kies de zoekscope
Gebruik methoden op TextFrame om een bewerking te beperken tot één tekstframe. Gebruik methoden op Presentation om alle toepasselijke tekst in de presentatie te verwerken.
| Bewerking | Één tekstframe | Gehele presentatie |
|---|---|---|
| Markeer letterlijke tekst | TextFrame.highlightText | Presentation.highlightText |
| Markeer reguliere‑expressie‑overeenkomsten | TextFrame.highlightRegex | Presentation.highlightRegex |
| Vervang letterlijke tekst | TextFrame.replaceText | Presentation.replaceText |
| Vervang reguliere‑expressie‑overeenkomsten | TextFrame.replaceRegex | Presentation.replaceRegex |
Configureer tekstmatching
Voor bewerkingen met letterlijke tekst, gebruik TextSearchOptions om de zoekopdracht te sturen:
- setWholeWordsOnly beperkt overeenkomsten tot volledige woorden.
- setCaseSensitive beheert of hoofdlettergebruik moet overeenkomen.
- setIncludeNotes neemt aantekeningen van dia’s op in zoek-, vervang‑ en markeerbewerkingen op presentatieniveau.
Bewerkingen met reguliere expressies gebruiken een Java Pattern, zodat regels voor zoeken, zoals hoofdlettergevoeligheid en woordgrenzen, worden gedefinieerd door de expressie en zijn vlaggen.
Identificeer de eigenaar van een TextFrame
Algemene tekstverwerkings‑workflows ontvangen vaak een TextFrame tijdens zoeken, vervangen, valideren of exporteren. Gebruik TextFrame.getParentShape en TextFrame.getParentCell om te bepalen welk presentatie‑object het tekstframe bezit.
De verwachte waarden hangen af van de eigenaar:
| Eigenaar van TextFrame | getParentShape |
getParentCell |
|---|---|---|
| Een AutoShape of een andere vorm die tekst bevat | De behorende Shape | None |
| Een tabelcel | None |
De behorende Cell |
Beide methoden bieden alleen‑lezen navigatie. Het aanroepen ervan verplaatst het tekstframe niet en verandert de eigenaar niet. Generieke code moet beide waarden op None controleren en de mogelijkheid afhandelen dat geen van beide beschikbaar is.
Het onderstaande voorbeeld gebruikt SlideUtil.getAllTextFrames om door de tekstframes in een presentatie te itereren. Voor vormen rapporteert het de vormnaam, het Java‑runtime‑type en de bijbehorende dia. Voor tabelcellen rapporteert het de nul‑gebaseerde kolom‑ en rij‑coördinaten en de bijbehorende dia.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Voor SmartArt‑inhoud itereren we door de vormen in SmartArtNode.getShapes en benaderen we elk SmartArtShape.getTextFrame. Het tekstframe kan worden getraceerd naar de bijbehorende vorm via TextFrame.getParentShape, terwijl TextFrame.getParentCell None retourneert. Daarom behandelt de vorm‑tak in het voorbeeld ook tekst uit SmartArt‑knopen.
Verzamel overeenkomstdetails met een callback
Implementeer IFindResultCallback via jpype.JProxy om een melding te ontvangen voor elke overeenkomst. De foundResult‑methode levert het bijbehorende tekstframe, de brontekst, de gevonden tekst en de positie van de overeenkomst.
De callback ontvangt geen dia‑nummer rechtstreeks. De implementatie hieronder haalt het dia‑nummer uit de bovenliggende dia en verwerkt ook tekst die in dia‑notities wordt gevonden. Een optioneel dia‑nummer maakt het mogelijk om hetzelfde resultaatsmodel te gebruiken voor tekst die met andere soort dia’s is geassocieerd.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Voor vervang‑bewerkingen bevat found_text de originele gevonden tekst, zodat de callback exact kan registreren welke termen zijn vervangen.
Markeer tekst
Gebruik de TextFrame.highlightText‑methode om letterlijke tekstovereenkomsten in een tekstframe te markeren. Geef [TextSearchOptions] door om de zoekopdracht te sturen en een callback om overeenkomstdetails te verzamelen.
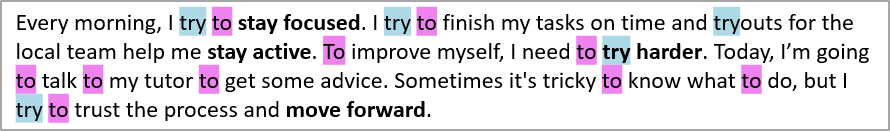
Het code‑voorbeeld hieronder markeert alle voorkomens van de tekens “try” en daarna alleen het volledige woord “to”. Beide zoekopdrachten melden hun resultaten aan dezelfde callback.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Markeer elk voorkomen van "try" in het tekstframe.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Markeer alleen het volledige woord "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Het resultaat:
Markeer tekst met reguliere expressies
De TextFrame.highlightRegex‑methode markeert tekstovereenkomsten die door een reguliere expressie in een tekstframe worden gevonden.
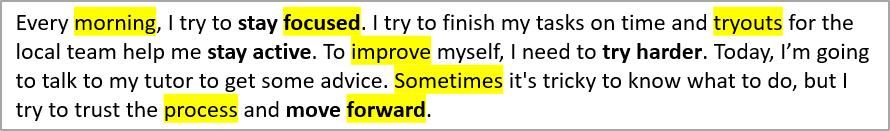
De volgende code markeert alle woorden die zeven of meer tekens bevatten en verzamelt elke overeenkomst:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Het resultaat:
Markeer tekst door een presentatie heen
Gebruik Presentation.highlightText en Presentation.highlightRegex om alle toepasselijke tekstframes in een presentatie te doorzoeken. Het onderstaande voorbeeld markeert een letterlijke term en alle e‑mailadressen, met aparte resultaatsverzamelingen voor de twee zoekopdrachten.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Vervang tekst in een TextFrame
Gebruik TextFrame.replaceText voor letterlijke tekst en TextFrame.replaceRegex voor patroon‑gebaseerde vervanging. Deze methoden werken de gevonden tekst bij binnen het bestaande tekstframe, waardoor de opmaak van het omringende gedeelte behouden blijft in plaats van het tekstframe opnieuw op te bouwen uit een platte string.
Het volgende voorbeeld normaliseert een spellingsvariant en vervangt vervolgens versielabels. Dezelfde callback registreert de oorspronkelijke termen die door beide bewerkingen zijn gevonden.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Als één overeenkomst delen met verschillende opmaak omvat, controleer dan de output om te bevestigen welke opmaak op de vervangende tekst moet worden toegepast.
Vervang tekst door een presentatie heen
Gebruik Presentation.replaceText en Presentation.replaceRegex om dezelfde bewerkingen over de hele presentatie toe te passen. Dit is nuttig voor het opschonen van sjablonen, het updaten van terminologie en redactie.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Groepeer overeenkomsten voor rapportage
Omdat elk resultaat zijn dia‑nummer en tekstframe opslaat, kunnen applicaties overeenkomsten groeperen voor audit, rapportage of review‑workflows. Het onderstaande voorbeeld groepeert de verzamelde resultaten eerst per dia en daarna per tekstframe:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
Veelgestelde vragen
Hoe kan ik slechts één tekstvak doorzoeken in plaats van de hele presentatie?
Haal het tekstframe van de vorm op en roep TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText of TextFrame.replaceRegex aan op dat tekstframe. Methoden op presentatieniveau verwerken alle toepasselijke tekstframes in plaats daarvan.
Hoe kan ik volledige woorden met de juiste hoofdletters vinden?
Stel TextSearchOptions.setWholeWordsOnly en TextSearchOptions.setCaseSensitive in op True en geef de opties door aan een letterlijke‑tekst‑markeer‑ of vervangingsmethode. Voor reguliere expressies definieer je woordgrenzen en hoofdlettergevoeligheid direct in de Java‑Pattern.
Kunnen zoeken en vervangen tekst in dia‑notities omvatten?
Ja. Stel TextSearchOptions.setIncludeNotes in op True bij het gebruik van een presentatie‑niveau‑letterlijke‑tekst‑bewerking. De hierboven getoonde callback‑implementatie mappt een overeenkomst in een notitiedia terug naar het bijbehorende dia‑nummer.
Hoe kan ik een rapport maken zonder de presentatie een tweede keer te scannen?
Geef een IFindResultCallback‑implementatie door aan de markeer‑ of vervangingsbewerking. De callback ontvangt elke overeenkomst terwijl de bewerking wordt uitgevoerd, zodat de applicatie de brontekst, gevonden tekst, positie, tekstframe en afgeleid dia‑nummer kan opslaan voor latere groepering of export.
Behoudt het vervangen van tekst de opmaak?
TextFrame.replaceText en TextFrame.replaceRegex wijzigen de gevonden tekst binnen het bestaande tekstframe en behouden de opmaak van het omringende gedeelte. Als een overeenkomst delen met verschillende opmaak omvat, inspecteer dan het resultaat om te verzekeren dat de vervanging de gewenste stijl gebruikt.