
Python via Java में PowerPoint प्रस्तुतियों में टेक्स्ट खोजें और बदलें
अवलोकन
Aspose.Slides for Python via Java व्यक्तिगत टेक्स्ट फ्रेम या पूरी प्रस्तुति में पाठ को खोज, हाइलाइट और प्रतिस्थापित कर सकता है। प्रत्येक ऑपरेशन परिणाम कॉलबैक के माध्यम से प्रत्येक मिलान के बारे में एप्लिकेशन को सूचित भी कर सकता है। इससे प्रस्तुति को अपडेट करते हुए मिलान किए गए पाठ, उसका संदर्भ, स्थिति, टेक्स्ट फ्रेम और स्लाइड क्रमांक सहित एक ऑडिट ट्रेल बनाना संभव हो जाता है।
इन क्षमताओं का उपयोग समीक्षा, संवेदनशील जानकारी हटाने, शब्दावली जांच, टेम्प्लेट सफ़ाई और स्वचालित रिपोर्टिंग वर्कफ़्लोज़ में किया जा सकता है।
नीचे पहले उदाहरणों में, हम “sample.pptx” नामक फ़ाइल का उपयोग करते हैं, जिसमें पहली स्लाइड पर एकल टेक्स्ट बॉक्स है जिसमें निम्नलिखित पाठ है:
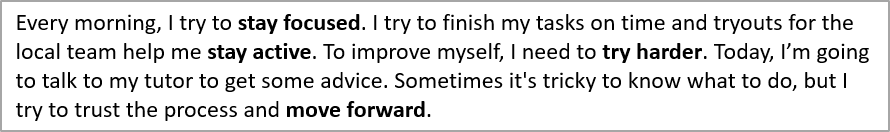
खोज सीमा चुनें
ऑपरेशन को एक टेक्स्ट फ्रेम तक सीमित करने के लिए TextFrame की विधियों का उपयोग करें। प्रस्तुति में सभी लागू पाठ को प्रोसेस करने के लिए Presentation की विधियों का उपयोग करें।
| ऑपरेशन | एक टेक्स्ट फ्रेम | पूरी प्रस्तुति |
|---|---|---|
| शाब्दिक पाठ को हाइलाइट करें | TextFrame.highlightText | Presentation.highlightText |
| रेगुलर एक्सप्रेशन मिलानों को हाइलाइट करें | TextFrame.highlightRegex | Presentation.highlightRegex |
| शाब्दिक पाठ को बदलें | TextFrame.replaceText | Presentation.replaceText |
| रेगुलर एक्सप्रेशन मिलानों को बदलें | TextFrame.replaceRegex | Presentation.replaceRegex |
पाठ मिलान को कॉन्फ़िगर करें
शाब्दिक-टेक्स्ट ऑपरेशनों के लिए, मिलान को नियंत्रित करने हेतु TextSearchOptions का उपयोग करें:
- setWholeWordsOnly मिलानों को पूर्ण शब्दों तक सीमित करता है।
- setCaseSensitive नियंत्रित करता है कि अक्षर केस मेल करना चाहिए या नहीं।
- setIncludeNotes प्रस्तुति-स्तर के खोज, प्रतिस्थापन और हाइलाइटिंग ऑपरेशनों में स्लाइड नोट्स को शामिल करता है।
रेगुलर एक्सप्रेशन ऑपरेशनों में Java Pattern का उपयोग किया जाता है, इसलिए केस संवेदनशीलता और शब्द सीमाओं जैसे नियम अभिव्यक्ति और उसके फ़्लैग द्वारा परिभाषित होते हैं।
टेक्स्ट फ्रेम के मालिक की पहचान करें
जनरल टेक्स्ट‑प्रोसेसिंग वर्कफ़्लोज़ अक्सर खोज, प्रतिस्थापन, मान्यकरण या निर्यात के दौरान एक TextFrame प्राप्त करते हैं। यह निर्धारित करने के लिए कि किस प्रस्तुति ऑब्जेक्ट के पास वह टेक्स्ट फ्रेम है, उपयोग करें TextFrame.getParentShape और TextFrame.getParentCell ।
अपेक्षित मान मालिक पर निर्भर करते हैं:
| टेक्स्ट फ्रेम मालिक | getParentShape |
getParentCell |
|---|---|---|
| एक AutoShape या अन्य टेक्स्ट‑धारक आकार | स्वामित्व वाला Shape | None |
| एक तालिका कोशिका | None |
स्वामित्व वाला Cell |
दोनों विधियां केवल‑पढ़ने योग्य नेविगेशन प्रदान करती हैं। उन्हें बुलाना टेक्स्ट फ्रेम को नहीं घूमाता nor उसके मालिक को नहीं बदलता। जनरल कोड को दोनों मानों को None के लिए जांचना चाहिए और इस संभावना को संभालना चाहिए कि कोई भी मालिक उपलब्ध न हो।
निम्न उदाहरण प्रस्तुति में सभी टेक्स्ट फ्रेम को इटरनेट करने के लिए SlideUtil.getAllTextFrames का उपयोग करता है। आकारों के लिए यह आकार का नाम, Java रन‑टाइम प्रकार और सम्मिलित स्लाइड रिपोर्ट करता है। तालिका कोशिकाओं के लिए यह शून्य‑आधारित कॉलम और पंक्ति निर्देशांक तथा सम्मिलित स्लाइड रिपोर्ट करता है।
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
SmartArt सामग्री के लिए, SmartArtNode.getShapes में आकारों को इटरनेट करें और प्रत्येक SmartArtShape.getTextFrame तक पहुंचें। टेक्स्ट फ्रेम को उसके सम्बंधित आकार तक TextFrame.getParentShape के माध्यम से ट्रेस किया जा सकता है, जबकि TextFrame.getParentCell None लौटाता है। इसलिए उदाहरण में आकार शाखा SmartArt नोड्स से मिलने वाले टेक्स्ट को भी संभालती है।
कॉलबैक के साथ मिलान जानकारी एकत्रित करें
jpype.JProxy के माध्यम से IFindResultCallback को लागू करें ताकि प्रत्येक मिलान पर सूचना प्राप्त हो सके। उसकी foundResult विधि सम्बंधित टेक्स्ट फ्रेम, स्रोत पाठ, मिलाया गया पाठ और मिलान स्थिति प्रदान करती है।
कॉलबैक सीधे स्लाइड क्रमांक प्राप्त नहीं करता। नीचे का कार्यान्वयन इसे पैरेंट स्लाइड से निकालता है और स्लाइड नोट्स में मिला पाठ भी संभालता है। एक वैकल्पिक स्लाइड क्रमांक समान परिणाम मॉडल को अन्य प्रकार की स्लाइड से जुड़े पाठ को दर्शाने की अनुमति देता है।
import jpime
import asposeslides

if not jpype.isJVMStarted():
    jpime.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
प्रतिस्थापन ऑपरेशनों के लिए, found_text में मूल मिलाया गया पाठ होता है, इसलिए कॉलबैक ठीक‑ठीक कौन से शब्द बदले गए थे, उसे रिकॉर्ड कर सकता है।
पाठ हाइलाइट करें
एक टेक्स्ट फ्रेम में शाब्दिक‑टेक्स्ट मिलानों को हाइलाइट करने के लिए TextFrame.highlightText विधि का उपयोग करें। खोज को नियंत्रित करने के लिए TextSearchOptions पास करें और मिलान विवरण एकत्र करने के लिए एक कॉलबैक प्रदान करें।
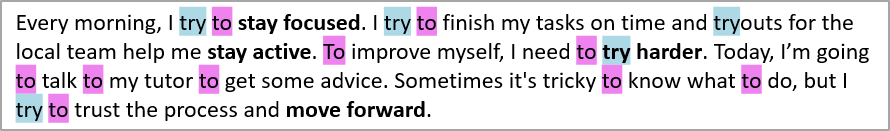
नीचे का कोड उदाहरण सभी “try” अक्षरों को हाइलाइट करता है और फिर केवल पूरा शब्द “to” को हाइलाइट करता है। दोनों खोजें अपने मिलानों को उसी कॉलबैक को रिपोर्ट करती हैं।
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # टेक्स्ट फ्रेम में "try" की प्रत्येक प्रकट को हाइलाइट करें।
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # केवल पूर्ण शब्द "to" को हाइलाइट करें।
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
परिणाम:
रेगुलर एक्सप्रेशन का उपयोग करके पाठ हाइलाइट करें
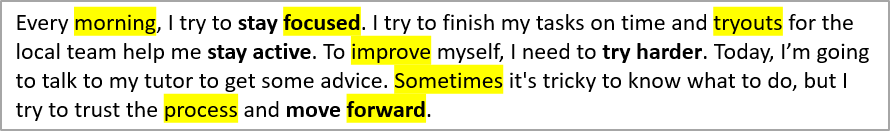
TextFrame.highlightRegex विधि रेगुलर एक्सप्रेशन द्वारा पाए गए पाठ मिलानों को एक टेक्स्ट फ्रेम में हाइलाइट करती है।
निम्न कोड सभी सात या अधिक अक्षर वाले शब्दों को हाइलाइट करता है और प्रत्येक मिलान को एकत्र करता है:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
परिणाम:
पूरी प्रस्तुति में पाठ हाइलाइट करें
पूरी प्रस्तुति में सभी लागू टेक्स्ट फ्रेम को खोजने के लिए Presentation.highlightText और Presentation.highlightRegex का उपयोग करें। नीचे का उदाहरण एक शाब्दिक शब्द और सभी ई‑मेल पतों को हाइलाइट करता है, जबकि दो खोजों के लिए अलग‑अलग परिणाम संग्रह बनाए रखता है।
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
टेक्स्ट फ्रेम में पाठ बदलें
शाब्दिक पाठ के लिए TextFrame.replaceText और पैटर्न‑आधारित प्रतिस्थापन के लिए TextFrame.replaceRegex का उपयोग करें। ये विधियां मौजूदा टेक्स्ट फ्रेम के भीतर मिलाए गए पाठ को अपडेट करती हैं, जिससे आसपास के भाग की फ़ॉर्मेटिंग बरकरार रहती है और पूरी स्ट्रिंग से नया फ्रेम बनाने की आवश्यकता नहीं पड़ती।
निम्न उदाहरण एक वर्तनी रूपांतर को मानकीकृत करता है और फिर संस्करण लेबल बदलता है। वही कॉलबैक दोनों ऑपरेशनों द्वारा मिलाए गए मूल शब्दों को रिकॉर्ड करता है।
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
यदि कोई मिलान विभिन्न फ़ॉर्मेटिंग वाले भागों को कवर करता है, तो आउटपुट की समीक्षा करें ताकि यह पुष्टि हो सके कि किस फ़ॉर्मेटिंग को प्रतिस्थापन पाठ पर लागू किया जाना चाहिए।
पूरी प्रस्तुति में पाठ बदलें
समान ऑपरेशनों को पूरी प्रस्तुति में लागू करने के लिए Presentation.replaceText और Presentation.replaceRegex का उपयोग करें। यह टेम्प्लेट सफ़ाई, शब्दावली अद्यतन और संवेदनशील जानकारी हटाने के लिए उपयोगी है।
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpipe.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
रिपोर्टिंग के लिए मिलान समूह बनाएं
चूंकि प्रत्येक परिणाम अपना स्लाइड क्रमांक और टेक्स्ट फ्रेम संग्रहीत करता है, एप्लिकेशन ऑडिट, रिपोर्टिंग या समीक्षा वर्कफ़्लोज़ के लिए मिलानों को समूहित कर सकते हैं। नीचे का उदाहरण पहले स्लाइड के अनुसार और फिर टेक्स्ट फ्रेम के अनुसार एकत्रित परिणामों को समूहित करता है:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
मैं पूरी प्रस्तुति के बजाय केवल एक टेक्स्ट बॉक्स को कैसे खोज सकता हूँ?
आकार की टेक्स्ट फ्रेम प्राप्त करें और उस टेक्स्ट फ्रेम पर TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText या TextFrame.replaceRegex को कॉल करें। प्रस्तुति‑स्तर की विधियां सभी लागू टेक्स्ट फ्रेम को प्रोसेस करती हैं।
मैं सही कैपीटलाइज़ेशन के साथ पूर्ण शब्द कैसे मिलाऊँ?
TextSearchOptions.setWholeWordsOnly और TextSearchOptions.setCaseSensitive को True पर सेट करें और विकल्पों को शाब्दिक‑टेक्स्ट हाइलाइटिंग या प्रतिस्थापन विधि में पास करें। रेगुलर एक्सप्रेशन के लिए, शब्द सीमाएं और केस‑संवेदनशीलता को Java Pattern में स्वयं परिभाषित करें।
क्या खोज और प्रतिस्थापन स्लाइड नोट्स में पाठ को शामिल कर सकता है?
हाँ। प्रस्तुति‑स्तर की शाब्दिक‑टेक्स्ट ऑपरेशन का उपयोग करते समय TextSearchOptions.setIncludeNotes को True पर सेट करें। ऊपर दिखाया गया कॉलबैक इम्प्लीमेंटेशन नोट्स स्लाइड में मिलान को उसके पैरेंट स्लाइड क्रमांक पर मैप करता है।
मैं प्रस्तुति को दूसरी बार स्कैन किए बिना रिपोर्ट कैसे बना सकता हूँ?
हाइलाइट या प्रतिस्थापन ऑपरेशन को एक IFindResultCallback इम्प्लीमेंटेशन पास करें। कॉलबैक ऑपरेशन के चलने के दौरान हर मिलान प्राप्त करता है, जिससे एप्लिकेशन स्रोत पाठ, मिलाया गया पाठ, स्थिति, टेक्स्ट फ्रेम और निकाला गया स्लाइड क्रमांक को बाद में समूहित या एक्सपोर्ट करने के लिए संचित कर सकता है।
क्या पाठ बदलने से उसकी फ़ॉर्मेटिंग बनी रहती है?
TextFrame.replaceText और TextFrame.replaceRegex मौजूदा टेक्स्ट फ्रेम के भीतर मिलाए गए पाठ को संशोधित करती हैं और आसपास के हिस्से की फ़ॉर्मेटिंग को बरकरार रखती हैं। यदि मिलान विभिन्न फ़ॉर्मेटिंग वाले भागों को कवर करता है, तो यह सुनिश्चित करने के लिए परिणाम की जांच करें कि प्रतिस्थापन वांछित शैली का उपयोग करता है।