
Vyhledávání a nahrazování textu v prezentacích PowerPoint v Pythonu přes Java
Přehled
Aspose.Slides for Python via Java může prohledávat, zvýrazňovat a nahrazovat text v jednotlivém textovém rámci nebo v celé prezentaci. Každá operace může také upozornit aplikaci na každý výskyt prostřednictvím zpětného volání výsledku. To umožňuje aktualizovat prezentaci a současně vytvářet auditní stopu obsahující nalezený text, jeho kontext, pozici, textový rámec a číslo snímku.
Tyto možnosti jsou užitečné pro revizi, redakci, kontrolu terminologie, čištění šablon a automatizované workflow pro reportování.
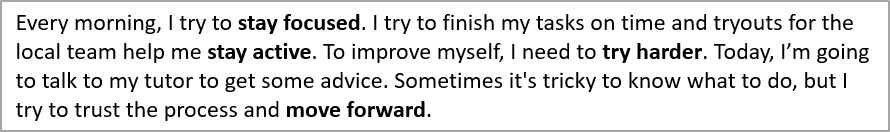
V následujících úvodních příkladech používáme soubor nazvaný “sample.pptx”, který obsahuje jediný textový rámeček na první snímku s následujícím textem:
Zvolte rozsah vyhledávání
Použijte metody třídy TextFrame k omezení operace na jeden textový rámec. Použijte metody třídy Presentation ke zpracování veškerého použitelného textu v prezentaci.
| Operace | Jeden textový rámec | Celá prezentace |
|---|---|---|
| Highlight literal text | TextFrame.highlightText | Presentation.highlightText |
| Highlight regular-expression matches | TextFrame.highlightRegex | Presentation.highlightRegex |
| Replace literal text | TextFrame.replaceText | Presentation.replaceText |
| Replace regular-expression matches | TextFrame.replaceRegex | Presentation.replaceRegex |
Nastavení shody textu
Pro operace s doslovným textem použijte TextSearchOptions k řízení shody:
- setWholeWordsOnly omezuje shody na celá slova.
- setCaseSensitive určuje, zda musí být zachována velikost písmen.
- setIncludeNotes zahrnuje poznámky ke snímkům do operací hledání, nahrazování a zvýrazňování na úrovni celé prezentace.
Operace s regulárním výrazem používají Java Pattern, takže pravidla shody, jako je citlivost na velikost písmen a hranice slov, jsou definována výrazem a jeho příznaky.
Identifikace vlastníka textového rámce
Obecné workflow pro zpracování textu často získávají TextFrame při hledání, nahrazování, validaci nebo exportu textu. Použijte TextFrame.getParentShape a TextFrame.getParentCell k určení, který objekt prezentace vlastní textový rámec.
Očekávané hodnoty závisí na vlastníkovi:
| Vlastník textového rámce | getParentShape |
getParentCell |
|---|---|---|
| AutoShape nebo jiný tvar obsahující text | Vlastní Shape | None |
| Buňka tabulky | None |
Vlastní Cell |
Obě metody poskytují jen pro čtení navigaci. Volání jich nepřesouvá textový rámec ani nemění jeho vlastníka. Obecný kód by měl kontrolovat obě hodnoty na None a ošetřit možnost, že žádný vlastník není k dispozici.
Následující příklad používá SlideUtil.getAllTextFrames k iteraci přes textové rámce v prezentaci. Pro tvary vypisuje název tvaru, typ runtime Java a obsahující snímek. Pro buňky tabulky vypisuje nulové indexy sloupce a řádku a obsahující snímek.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Pro obsah SmartArt iterujte přes tvary v SmartArtNode.getShapes a přistupujte k jednotlivým SmartArtShape.getTextFrame. Textový rámec lze sledovat k příslušnému tvaru pomocí TextFrame.getParentShape, zatímco TextFrame.getParentCell vrací None. Proto větev pro tvary v příkladu také zpracovává text ze SmartArt uzlů.
Shromažďování informací o shodách pomocí zpětného volání
Implementujte IFindResultCallback pomocí jpype.JProxy pro získání oznámení o každé shodě. Jeho metoda foundResult poskytuje související textový rámec, původní text, nalezený text a pozici shody.
Zpětné volání nedostává číslo snímku přímo. Implementace níže jej získává z nadřazeného snímku a také zpracovává text nalezený v poznámkách ke snímku. Volitelné číslo snímku umožňuje, aby stejný model výsledku reprezentoval text spojený s jinými typy snímků.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Pro operace nahrazování found_text obsahuje původní nalezený text, takže zpětné volání může zaznamenat přesně, které termíny byly nahrazeny.
Zvýraznění textu
Použijte metodu TextFrame.highlightText k zvýraznění doslovných shod v textovém rámci. Předávejte TextSearchOptions , aby řídily vyhledávání, a zpětné volání pro sběr detailů o shodách.
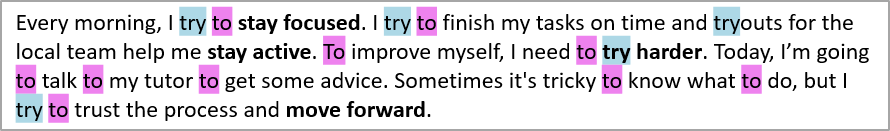
Níže uvedený příklad zdůrazňuje všechny výskyty znaků “try” a poté zvýrazňuje pouze celé slovo “to”. Obě vyhledávání hlásí své shody stejnému zpětnému volání.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Zvýraznit každý výskyt "try" v textovém rámci.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Zvýraznit pouze celé slovo "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Výsledek:
Zvýraznění textu pomocí regulárních výrazů
Metoda TextFrame.highlightRegex zvýrazňuje shody textu nalezené regulárním výrazem v textovém rámci.
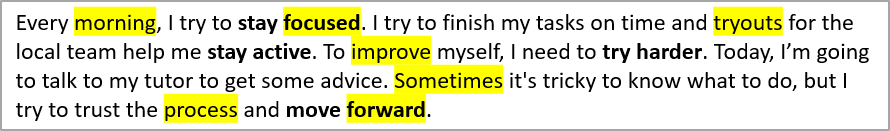
Následující kód zvýrazňuje všechna slova obsahující sedm a více znaků a sbírá každou shodu:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Výsledek:
Zvýraznění textu napříč prezentací
Použijte Presentation.highlightText a Presentation.highlightRegex k prohledání všech použitelných textových rámců v prezentaci. Následující příklad zvýrazňuje doslovný termín a všechny e‑mailové adresy, přičemž udržuje samostatné sbírky výsledků pro obě vyhledávání.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Nahrazení textu v textovém rámci
Použijte TextFrame.replaceText pro doslovný text a TextFrame.replaceRegex pro nahrazování založené na vzoru. Tyto metody aktualizují nalezený text v existujícím textovém rámci, přičemž zachovávají formátování okolních částí místo přestavby rámce z prostého řetězce.
Následující příklad standardizuje variantu pravopisu a poté nahrazuje štítky verzí. Stejné zpětné volání zaznamenává původní termíny nalezené v obou operacích.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Pokud jedna shoda zasahuje do částí s odlišným formátováním, zkontrolujte výstup a potvrďte, které formátování by mělo být použito pro nahrazovaný text.
Nahrazení textu napříč prezentací
Použijte Presentation.replaceText a Presentation.replaceRegex k aplikaci stejných operací napříč prezentací. To je užitečné pro čištění šablon, aktualizaci terminologie a redakci.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Skupinové shody pro reportování
Protože každý výsledek ukládá číslo snímku a textový rámec, aplikace mohou shody seskupovat pro audit, reportování nebo revizní workflow. Následující příklad seskupuje shromážděné výsledky nejprve podle snímku a poté podle textového rámce:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
Časté otázky
Jak mohu hledat pouze v jedné textové oblasti místo celé prezentace?
Získejte textový rámec tvaru a zavolejte na něm TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText nebo TextFrame.replaceRegex. Metody na úrovni prezentace zpracovávají všechny použitelné textové rámce.
Jak mohu shodovat celá slova s správnou kapitalizací?
Nastavte TextSearchOptions.setWholeWordsOnly a TextSearchOptions.setCaseSensitive na True a předávejte možnosti metodě pro zvýraznění nebo nahrazení doslovného textu. Pro regulární výrazy definujte hranice slov a citlivost na velikost písmen přímo v Java Pattern.
Může vyhledávání a nahrazování zahrnovat text v poznámkách ke snímkům?
Ano. Nastavte TextSearchOptions.setIncludeNotes na True při použití operace doslovného textu na úrovni prezentace. Implementace zpětného volání uvedená výše mapuje shodu v poznámkovém snímku zpět na číslo nadřazeného snímku.
Jak mohu vytvořit report bez druhého skenování prezentace?
Předávejte implementaci IFindResultCallback do operace zvýraznění nebo nahrazování. Zpětné volání přijímá každou shodu během běhu operace, takže aplikace může uložit původní text, nalezený text, pozici, textový rámec a odvozené číslo snímku pro pozdější seskupování nebo export.
Zachovává nahrazení textu jeho formátování?
TextFrame.replaceText a TextFrame.replaceRegex upravují nalezený text v existujícím textovém rámci a zachovávají formátování okolních částí. Pokud shoda zasahuje do částí s odlišným formátováním, zkontrolujte výsledek, aby bylo jisté, že nahrazení použije požadovaný styl.