
Pesquisar e Substituir Texto em Apresentações PowerPoint em Python via Java
Visão geral
Aspose.Slides for Python via Java pode pesquisar, destacar e substituir texto em um quadro de texto individual ou em toda a apresentação. Cada operação também pode notificar um aplicativo sobre cada correspondência por meio de um callback de resultado. Isso permite atualizar uma apresentação e, simultaneamente, criar um registro de auditoria contendo o texto correspondido, seu contexto, posição, quadro de texto e número do slide.
Essas funcionalidades são úteis para revisão, redaction, verificação de terminologia, limpeza de modelos e fluxos de trabalho de geração automática de relatórios.
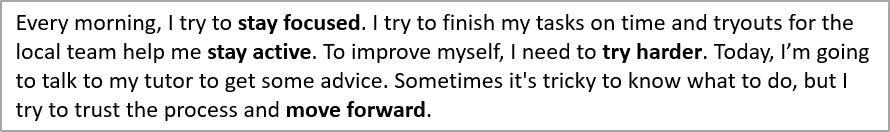
Nos primeiros exemplos abaixo, usamos um arquivo chamado “sample.pptx”, que contém uma única caixa de texto no primeiro slide com o seguinte texto:
Escolher o escopo da pesquisa
Use métodos em TextFrame para limitar uma operação a um quadro de texto. Use métodos em Presentation para processar todo o texto aplicável na apresentação.
| Operação | Um quadro de texto | Apresentação inteira |
|---|---|---|
| Destacar texto literal | TextFrame.highlightText | Presentation.highlightText |
| Destacar correspondências de expressão regular | TextFrame.highlightRegex | Presentation.highlightRegex |
| Substituir texto literal | TextFrame.replaceText | Presentation.replaceText |
| Substituir correspondências de expressão regular | TextFrame.replaceRegex | Presentation.replaceRegex |
Configurar a correspondência de texto
Para operações de texto literal, use TextSearchOptions para controlar a correspondência:
- setWholeWordsOnly limita as correspondências a palavras completas.
- setCaseSensitive controla se a capitalização dos caracteres deve coincidir.
- setIncludeNotes inclui anotações de slide nas operações de pesquisa, substituição e destaque em nível de apresentação.
Operações de expressão regular utilizam um Pattern Java, portanto regras de correspondência como sensibilidade a maiúsculas/minúsculas e limites de palavra são definidas pela expressão e suas flags.
Identificar o proprietário de um quadro de texto
Fluxos de trabalho genéricos de processamento de texto frequentemente recebem um TextFrame ao pesquisar, substituir, validar ou exportar texto. Use TextFrame.getParentShape e TextFrame.getParentCell para determinar qual objeto da apresentação possui o quadro de texto.
Os valores esperados dependem do proprietário:
| Proprietário do quadro de texto | getParentShape |
getParentCell |
|---|---|---|
| Um AutoShape ou outra forma que contenha texto | A Shape proprietária | None |
| Uma célula de tabela | None |
A Cell proprietária |
Ambos os métodos fornecem navegação somente leitura. Chamá‑los não move o quadro de texto nem altera seu proprietário. O código genérico deve verificar ambos os valores para None e tratar a possibilidade de que nenhum proprietário esteja disponível.
O exemplo a seguir usa SlideUtil.getAllTextFrames para percorrer os quadros de texto de uma apresentação. Para formas, ele relata o nome da forma, o tipo de tempo de execução Java e o slide contendo. Para células de tabela, ele relata as coordenadas de coluna e linha baseadas em zero e o slide contendo.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Para conteúdo SmartArt, percorra as formas em SmartArtNode.getShapes e acesse cada SmartArtShape.getTextFrame. O quadro de texto pode ser rastreado até sua forma associada por meio de TextFrame.getParentShape, enquanto TextFrame.getParentCell retorna None. Portanto, o ramo de forma no exemplo também trata texto proveniente de nós SmartArt.
Coletar informações de correspondência com um callback
Implemente IFindResultCallback através de jpype.JProxy para receber uma notificação para cada correspondência. Seu método foundResult fornece o quadro de texto relacionado, o texto fonte, o texto correspondido e a posição da correspondência.
O callback não recebe diretamente o número do slide. A implementação abaixo o deriva do slide pai e também trata texto encontrado em anotações de slide. Um número de slide opcional permite que o mesmo modelo de resultado represente texto associado a outros tipos de slide.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Para operações de substituição, found_text contém o texto original correspondido, de modo que o callback pode registrar exatamente quais termos foram substituídos.
Destacar texto
Use o método TextFrame.highlightText para destacar correspondências de texto literal em um quadro de texto. Passe TextSearchOptions para controlar a pesquisa e um callback para coletar detalhes da correspondência.
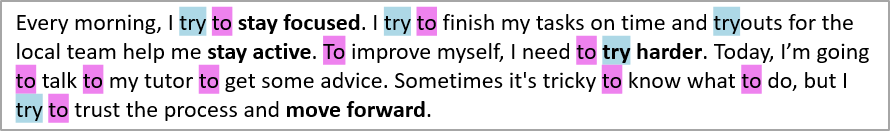
O exemplo de código abaixo destaca todas as ocorrências dos caracteres “try” e depois destaca apenas a palavra completa “to”. Ambas as pesquisas relatam suas correspondências ao mesmo callback.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Destacar cada ocorrência de "try" no quadro de texto.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Destacar apenas a palavra completa "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
O resultado:
Destacar texto usando expressões regulares
O método TextFrame.highlightRegex destaca correspondências de texto encontradas por uma expressão regular em um quadro de texto.
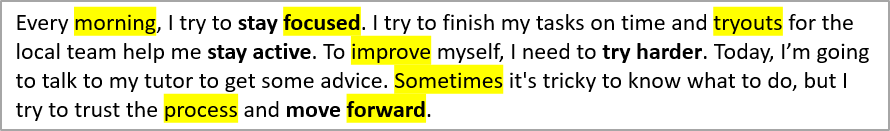
O código a seguir destaca todas as palavras que contêm sete ou mais caracteres e coleta cada correspondência:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
O resultado:
Destacar texto em toda a apresentação
Use Presentation.highlightText e Presentation.highlightRegex para pesquisar todos os quadros de texto aplicáveis em uma apresentação. O exemplo a seguir destaca um termo literal e todos os endereços de e‑mail mantendo coleções de resultados separadas para as duas buscas.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Substituir texto em um quadro de texto
Use TextFrame.replaceText para texto literal e TextFrame.replaceRegex para substituição baseada em padrão. Esses métodos atualizam o texto correspondido dentro do quadro de texto existente, que mantém a formatação da porção circundante em vez de reconstruir o quadro de texto a partir de uma string simples.
O exemplo a seguir padroniza uma variante ortográfica e depois substitui rótulos de versão. O mesmo callback registra os termos originais correspondidos por ambas as operações.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Se uma correspondência abranger partes com formatações diferentes, revise a saída para confirmar qual formatação deve ser aplicada ao texto substituto.
Substituir texto em toda a apresentação
Use Presentation.replaceText e Presentation.replaceRegex para aplicar as mesmas operações em toda a apresentação. Isso é útil para limpeza de modelos, atualizações terminológicas e redação.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Agrupar correspondências para relatórios
Como cada resultado armazena seu número de slide e quadro de texto, os aplicativos podem agrupar correspondências para auditoria, relatórios ou fluxos de trabalho de revisão. O exemplo a seguir agrupa os resultados coletados primeiro por slide e depois por quadro de texto:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
Perguntas frequentes
Como posso pesquisar apenas uma caixa de texto em vez de toda a apresentação?
Obtenha o quadro de texto da forma e chame TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText ou TextFrame.replaceRegex nesse quadro de texto. Os métodos em nível de apresentação processam todos os quadros de texto aplicáveis.
Como posso combinar palavras completas com a capitalização correta?
Defina TextSearchOptions.setWholeWordsOnly e TextSearchOptions.setCaseSensitive como True e passe as opções para um método de destaque ou substituição de texto literal. Para expressões regulares, defina limites de palavra e sensibilidade a maiúsculas/minúsculas no próprio Pattern Java.
A pesquisa e substituição podem incluir texto nas anotações de slide?
Sim. Defina TextSearchOptions.setIncludeNotes como True ao usar uma operação literal em nível de apresentação. A implementação do callback mostrada acima mapeia uma correspondência em um slide de notas de volta ao número do slide pai.
Como posso gerar um relatório sem analisar a apresentação uma segunda vez?
Passe uma implementação de IFindResultCallback para a operação de destaque ou substituição. O callback recebe cada correspondência enquanto a operação é executada, permitindo que o aplicativo armazene o texto fonte, texto correspondido, posição, quadro de texto e número de slide derivado para posterior agrupamento ou exportação.
A substituição de texto preserva sua formatação?
TextFrame.replaceText e TextFrame.replaceRegex modificam o texto correspondido dentro do quadro de texto existente e mantêm a formatação das partes ao redor. Se uma correspondência abranger porções com formatações diferentes, inspecione o resultado para garantir que a substituição use o estilo desejado.