
Wyszukiwanie i zamiana tekstu w prezentacjach PowerPoint w Pythonie poprzez Java
Przegląd
Aspose.Slides for Python via Java może wyszukiwać, podświetlać i zamieniać tekst w pojedynczej ramce tekstowej lub w całej prezentacji. Każda operacja może także powiadomić aplikację o każdym dopasowaniu za pomocą zwrotnego wywołania wyniku. Umożliwia to aktualizację prezentacji i jednoczesne tworzenie śladu audytu zawierającego dopasowany tekst, jego kontekst, pozycję, ramkę tekstową i numer slajdu.
Te możliwości są przydatne przy przeglądzie, redakcji, sprawdzaniu terminologii, czyszczeniu szablonów i automatyzacji raportowania.
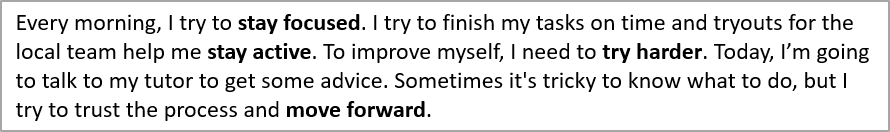
W poniższych pierwszych przykładach używamy pliku o nazwie “sample.pptx”, który zawiera jedną ramkę tekstową na pierwszym slajdzie z następującym tekstem:
Wybierz zakres wyszukiwania
Użyj metod na TextFrame aby ograniczyć operację do jednej ramki tekstowej. Użyj metod na Presentation aby przetworzyć cały odpowiedni tekst w prezentacji.
| Operacja | Jedna ramka tekstowa | Cała prezentacja |
|---|---|---|
| Podświetlenie tekstu dosłownego | TextFrame.highlightText | Presentation.highlightText |
| Podświetlenie dopasowań wyrażeniem regularnym | TextFrame.highlightRegex | Presentation.highlightRegex |
| Zamiana tekstu dosłownego | TextFrame.replaceText | Presentation.replaceText |
| Zamiana dopasowań wyrażeniem regularnym | TextFrame.replaceRegex | Presentation.replaceRegex |
Skonfiguruj dopasowywanie tekstu
W operacjach na tekście dosłownym użyj TextSearchOptions aby kontrolować dopasowanie:
- setWholeWordsOnly ogranicza dopasowania do całych wyrazów.
- setCaseSensitive określa, czy wielkość znaków musi się zgadzać.
- setIncludeNotes uwzględnia notatki slajdów w operacjach wyszukiwania, zamiany i podświetlania na poziomie prezentacji.
Operacje z wyrażeniami regularnymi używają klasy Java Pattern, więc reguły dopasowania, takie jak wrażliwość na wielkość liter i granice wyrazów, są definiowane w wyrażeniu i jego flagach.
Zidentyfikuj właściciela ramki tekstowej
Typowe przepływy przetwarzania tekstu często otrzymują TextFrame podczas wyszukiwania, zamiany, walidacji lub eksportu tekstu. Użyj TextFrame.getParentShape i TextFrame.getParentCell, aby określić, który obiekt prezentacji jest właścicielem ramki tekstowej.
Oczekiwane wartości zależą od właściciela:
| Właściciel ramki tekstowej | getParentShape |
getParentCell |
|---|---|---|
| AutoShape lub inny kształt zawierający tekst | Właścielski Shape | None |
| Komórka tabeli | None |
Właścielski Cell |
Obie metody zapewniają nawigację tylko do odczytu. Wywołanie ich nie przenosi ramki tekstowej ani nie zmienia jej właściciela. Ogólny kod powinien sprawdzać oba wyniki pod kątem None i obsługiwać sytuację, gdy żaden właściciel nie jest dostępny.
Poniższy przykład używa SlideUtil.getAllTextFrames do iteracji po wszystkich ramach tekstowych w prezentacji. Dla kształtów raportuje nazwę kształtu, typ w czasie wykonywania Java i slajd, w którym się znajduje. Dla komórek tabeli raportuje współrzędne kolumny i wiersza (liczone od zera) oraz slajd, w którym się znajdują.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Dla treści SmartArt iteruj po kształtach w SmartArtNode.getShapes i uzyskaj każdy SmartArtShape.getTextFrame. Ramka tekstowa może być powiązana z jej kształtem przy użyciu TextFrame.getParentShape, podczas gdy TextFrame.getParentCell zwraca None. Dlatego gałąź kształtu w przykładzie obsługuje także tekst z węzłów SmartArt.
Zbieraj informacje o dopasowaniach za pomocą zwrotnego wywołania
Zaimplementuj IFindResultCallback przy pomocy jpype.JProxy, aby otrzymywać powiadomienie o każdym dopasowaniu. Jego metoda foundResult dostarcza powiązaną ramkę tekstową, tekst źródłowy, dopasowany tekst oraz pozycję dopasowania.
Wywołanie zwrotne nie otrzymuje numeru slajdu bezpośrednio. Poniższa implementacja wyprowadza go z slajdu nadrzędnego i obsługuje także tekst znaleziony w notatkach slajdu. Opcjonalny numer slajdu pozwala na użycie tego samego modelu wyniku dla tekstu z innych typów slajdów.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Dla operacji zamiany, found_text zawiera oryginalny dopasowany tekst, więc wywołanie zwrotne może dokładnie zapisać, które terminy zostały zamienione.
Podświetlanie tekstu
Użyj metody TextFrame.highlightText, aby podświetlić dopasowania tekstu dosłownego w ramce tekstowej. Przekaż TextSearchOptions, aby kontrolować wyszukiwanie, oraz wywołanie zwrotne do zbierania szczegółów dopasowania.
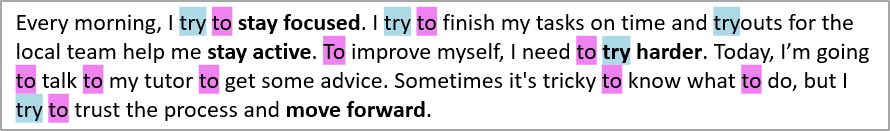
Poniższy przykład podświetla wszystkie wystąpienia znaków “try”, a następnie podświetla tylko całe słowo “to”. Oba wyszukiwania raportują dopasowania do tego samego wywołania zwrotnego.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Podświetl każde wystąpienie "try" w ramce tekstowej.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Podświetl tylko całe słowo "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Wynik:
Podświetlanie tekstu przy użyciu wyrażeń regularnych
Metoda TextFrame.highlightRegex podświetla dopasowania tekstu znalezione przez wyrażenie regularne w ramce tekstowej.
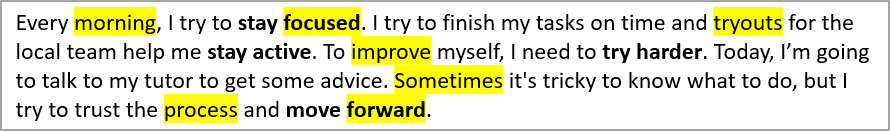
Poniższy kod podświetla wszystkie słowa zawierające siedem lub więcej znaków i zbiera każde dopasowanie:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Wynik:
Podświetlanie tekstu w całej prezentacji
Użyj Presentation.highlightText i Presentation.highlightRegex, aby przeszukać wszystkie odpowiednie ramki tekstowe w prezentacji. Poniższy przykład podświetla termin dosłowny oraz wszystkie adresy e‑mail, zachowując osobne kolekcje wyników dla obu wyszukiwań.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Zamiana tekstu w ramce tekstowej
Użyj TextFrame.replaceText dla tekstu dosłownego oraz TextFrame.replaceRegex dla zamiany opartej na wzorcu. Metody te aktualizują dopasowany tekst w istniejącej ramce tekstowej, zachowując formatowanie otaczających fragmentów zamiast przebudowywać ramkę z czystego łańcucha.
Poniższy przykład standaryzuje wariant pisowni, a następnie zamienia etykiety wersji. To samo wywołanie zwrotne zapisuje oryginalne terminy dopasowane w obu operacjach.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Jeśli jedno dopasowanie obejmuje fragmenty o różnym formatowaniu, sprawdź wynik, aby potwierdzić, które formatowanie ma zostać zastosowane do tekstu zamiany.
Zamiana tekstu w całej prezentacji
Użyj Presentation.replaceText i Presentation.replaceRegex, aby zastosować te same operacje w całej prezentacji. Jest to przydatne przy czyszczeniu szablonów, aktualizacji terminologii i redakcji.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Grupowanie dopasowań w raportach
Ponieważ każdy wynik przechowuje numer slajdu i ramkę tekstową, aplikacje mogą grupować dopasowania w celu audytu, raportowania lub przeglądu. Poniższy przykład najpierw grupuje zebrane wyniki według slajdu, a potem według ramki tekstowej:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
Jak mogę przeszukać tylko jedną ramkę tekstową zamiast całej prezentacji?
Pobierz ramkę tekstową kształtu i wywołaj TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText lub TextFrame.replaceRegex na tej ramce. Metody na poziomie prezentacji przetwarzają wszystkie odpowiednie ramki tekstowe.
Jak dopasować całe słowa z odpowiednią wielkością liter?
Ustaw TextSearchOptions.setWholeWordsOnly i TextSearchOptions.setCaseSensitive na True i przekaż opcje do metody podświetlania lub zamiany tekstu dosłownego. Dla wyrażeń regularnych zdefiniuj granice słów i wrażliwość na wielkość liter bezpośrednio w klasie Java Pattern.
Czy wyszukiwanie i zamiana mogą obejmować tekst w notatkach slajdów?
Tak. Ustaw TextSearchOptions.setIncludeNotes na True podczas używania operacji tekstu dosłownego na poziomie prezentacji. Implementacja wywołania zwrotnego przedstawiona powyżej mapuje dopasowanie w notatce na numer slajdu nadrzędnego.
Jak stworzyć raport bez ponownego skanowania prezentacji?
Przekaż implementację IFindResultCallback do operacji podświetlania lub zamiany. Wywołanie zwrotne otrzymuje każde dopasowanie w trakcie trwania operacji, więc aplikacja może zapisać tekst źródłowy, dopasowany tekst, pozycję, ramkę tekstową oraz wyprowadzony numer slajdu do późniejszego grupowania lub eksportu.
Czy zamiana tekstu zachowuje jego formatowanie?
TextFrame.replaceText i TextFrame.replaceRegex modyfikują dopasowany tekst w istniejącej ramce tekstowej i zachowują formatowanie otaczających fragmentów. Jeśli dopasowanie obejmuje fragmenty o różnym formatowaniu, sprawdź wynik, aby upewnić się, że zamiana używa pożądanego stylu.