
Поиск и замена текста в презентациях PowerPoint на Python через Java
Обзор
Aspose.Slides for Python via Java может выполнять поиск, подсветку и замену текста в отдельном текстовом кадре или во всей презентации. Каждая операция также может уведомлять приложение о каждом совпадении через обратный вызов результата. Это позволяет обновлять презентацию и одновременно создавать аудит‑трейл, содержащий найденный текст, его контекст, позицию, текстовый кадр и номер слайда.
Эти возможности полезны для проверки, редактирования, проверки терминологии, очистки шаблонов и автоматизированных рабочих процессов отчетности.
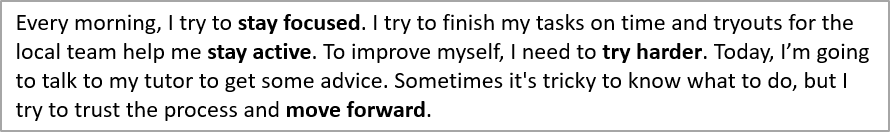
В первых примерах ниже используется файл с именем “sample.pptx”, который содержит один текстовый блок на первом слайде со следующим текстом:
Выберите область поиска
Используйте методы класса TextFrame для ограничения операции одним текстовым кадром. Используйте методы класса Presentation для обработки всего применимого текста в презентации.
| Операция | Один текстовый кадр | Вся презентация |
|---|---|---|
| Подсветка буквального текста | TextFrame.highlightText | Presentation.highlightText |
| Подсветка совпадений регулярных выражений | TextFrame.highlightRegex | Presentation.highlightRegex |
| Замена буквального текста | TextFrame.replaceText | Presentation.replaceText |
| Замена совпадений регулярных выражений | TextFrame.replaceRegex | Presentation.replaceRegex |
Настройка сопоставления текста
Для операций с буквальным текстом используйте TextSearchOptions для управления сопоставлением:
- setWholeWordsOnly ограничивает совпадения полными словами.
- setCaseSensitive определяет, должен ли учитываться регистр символов.
- setIncludeNotes включает примечания к слайдам в операции поиска, замены и подсветки на уровне презентации.
Операции с регулярными выражениями используют Java Pattern, поэтому правила сопоставления, такие как чувствительность к регистру и границы слов, задаются выражением и его флагами.
Определение владельца текстового кадра
Общие рабочие процессы обработки текста часто получают объект TextFrame , когда выполняют поиск, замену, проверку или экспорт текста. Используйте TextFrame.getParentShape и TextFrame.getParentCell, чтобы определить, какой объект презентации владеет текстовым кадром.
Ожидаемые значения зависят от владельца:
| Владелец текстового кадра | getParentShape |
getParentCell |
|---|---|---|
| Автофигура AutoShape или другая форма, содержащая текст | Владелец Shape | None |
| Ячейка таблицы | None |
Владелец Cell |
Оба метода предоставляют только чтение навигацию. Их вызов не перемещает текстовый кадр и не меняет его владельца. Универсальный код должен проверять оба значения на None и обрабатывать возможность отсутствия любого из владельцев.
Следующий пример использует SlideUtil.getAllTextFrames, чтобы пройтись по всем текстовым кадрам в презентации. Для фигур он выводит название фигуры, тип Java во время выполнения и содержащий слайд. Для ячеек таблицы он выводит координаты столбца и строки, начинающиеся с нуля, и содержащий слайд.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Для содержимого SmartArt пройдите по фигурам с помощью SmartArtNode.getShapes, а затем обратитесь к каждому SmartArtShape.getTextFrame. Текстовый кадр можно отследить к своей связанной фигуре через TextFrame.getParentShape, в то время как TextFrame.getParentCell возвращает None. Таким образом, ветка фигур в примере также обрабатывает текст из узлов SmartArt.
Сбор информации о совпадениях с помощью обратного вызова
Реализуйте IFindResultCallback через jpype.JProxy, чтобы получать уведомление о каждом совпадении. Его метод foundResult предоставляет связанный текстовый кадр, исходный текст, найденный текст и позицию совпадения.
Обратный вызов не получает номер слайда напрямую. Реализация ниже выводит его из родительского слайда и также обрабатывает текст, найденный в примечаниях к слайдам. Необязательный номер слайда позволяет одной модели результата представлять текст, связанный с другими типами слайдов.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Для операций замены found_text содержит исходный найденный текст, поэтому обратный вызов может точно зафиксировать, какие термины были заменены.
Подсветка текста
Используйте метод TextFrame.highlightText, чтобы подсветить совпадения буквального текста в текстовом кадре. Передайте TextSearchOptions , чтобы управлять поиском, и обратный вызов для сбора деталей совпадений.
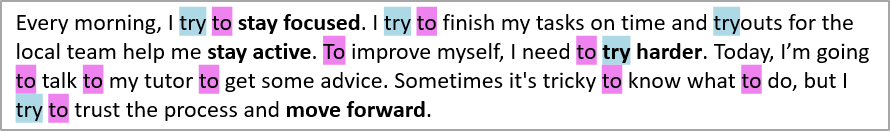
Пример кода ниже подсвечивает все вхождения символов “try” и затем подсвечивает только полное слово “to”. Оба поиска отправляют свои совпадения в один и тот же обратный вызов.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Выделить каждое вхождение "try" в текстовом кадре.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Выделить только полное слово "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Результат:
Подсветка текста с использованием регулярных выражений
Метод TextFrame.highlightRegex подсвечивает совпадения текста, найденные регулярным выражением, в текстовом кадре.
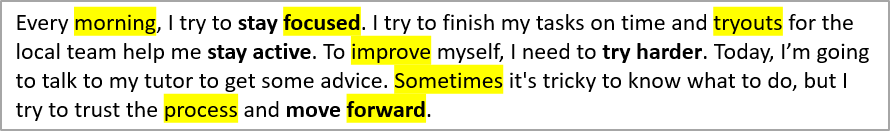
Следующий код подсвечивает все слова, содержащие семь и более символов, и собирает каждое совпадение:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Результат:
Подсветка текста по всей презентации
Используйте Presentation.highlightText и Presentation.highlightRegex, чтобы искать во всех применимых текстовых кадрах презентации. Следующий пример подсвечивает буквальный термин и все адреса электронной почты, при этом поддерживая отдельные коллекции результатов для двух поисков.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Замена текста в текстовом кадре
Используйте TextFrame.replaceText для буквального текста и TextFrame.replaceRegex для замены по шаблону. Эти методы обновляют найденный текст внутри существующего текстового кадра, сохраняя форматирование окружающих фрагментов вместо пересоздания кадра из простой строки.
Следующий пример стандартизирует вариант написания, а затем заменяет метки версий. Тот же обратный вызов фиксирует оригинальные термины, найденные обеими операциями.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Если одно совпадение охватывает части с разным форматированием, проверьте результат, чтобы подтвердить, какое форматирование должно применяться к заменяемому тексту.
Замена текста по всей презентации
Используйте Presentation.replaceText и Presentation.replaceRegex, чтобы применить одинаковые операции по всей презентации. Это полезно для очистки шаблонов, обновления терминологии и редактирования.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Группировка совпадений для отчетности
Поскольку каждый результат хранит номер слайда и текстовый кадр, приложения могут группировать совпадения для аудита, отчетности или обзора. Следующий пример группирует собранные результаты сначала по слайдам, а затем по текстовым кадрам:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
Как искать только один текстовый блок вместо всей презентации?
Получите текстовый кадр формы и вызовите TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText, или TextFrame.replaceRegex для этого кадра. Методы уровня презентации обрабатывают все применимые текстовые кадры.
Как сопоставить полные слова с правильным регистром?
Установите TextSearchOptions.setWholeWordsOnly и TextSearchOptions.setCaseSensitive в True и передайте параметры в метод подсветки или замены буквального текста. Для регулярных выражений определите границы слов и чувствительность к регистру непосредственно в Java Pattern.
Можно ли включить поиск и замену текста в примечания к слайдам?
Да. Установите TextSearchOptions.setIncludeNotes в True при использовании операции буквального текста уровня презентации. Реализация обратного вызова, показанная выше, сопоставляет совпадение в примечании к слайду с номером его родительского слайда.
Как создать отчет без повторного сканирования презентации?
Передайте реализацию IFindResultCallback в операцию подсветки или замены. Обратный вызов получает каждое совпадение во время выполнения операции, поэтому приложение может сохранять исходный текст, найденный текст, позицию, текстовый кадр и вычисленный номер слайда для последующей группировки или экспорта.
Сохраняет ли замена текста его форматирование?
TextFrame.replaceText и TextFrame.replaceRegex изменяют найденный текст внутри существующего текстового кадра и сохраняют форматирование окружающих участков. Если совпадение охватывает части с разным форматированием, проверьте результат, чтобы убедиться, что замена использует нужный стиль.