
Python via Java で PowerPoint プレゼンテーションのテキストを検索および置換
概要
Aspose.Slides for Python via Java は、個々のテキストフレームまたはプレゼンテーション全体でテキストの検索、ハイライト、置換を行うことができます。各操作は結果コールバックを通じてすべての一致をアプリケーションに通知でき、プレゼンテーションを更新しながら一致したテキスト、そのコンテキスト、位置、テキストフレーム、スライド番号を含む監査トレイルを同時に作成できます。
これらの機能は、レビュー、情報削除、用語チェック、テンプレートのクリーンアップ、そして自動レポート作成ワークフローに有用です。
以下の最初の例では、1枚目のスライドに単一のテキストボックスがあり、次のテキストが含まれる「sample.pptx」ファイルを使用します。
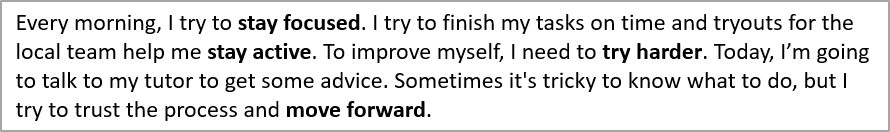
検索対象の選択
TextFrame のメソッドを使用すると、操作を 1 つのテキストフレームに限定できます。Presentation のメソッドを使用すると、プレゼンテーション内のすべての該当テキストを処理できます。
| 操作 | 1 つのテキストフレーム | プレゼンテーション全体 |
|---|---|---|
| リテラルテキストのハイライト | TextFrame.highlightText | Presentation.highlightText |
| 正規表現一致のハイライト | TextFrame.highlightRegex | Presentation.highlightRegex |
| リテラルテキストの置換 | TextFrame.replaceText | Presentation.replaceText |
| 正規表現一致の置換 | TextFrame.replaceRegex | Presentation.replaceRegex |
テキスト一致の設定
リテラルテキスト操作の場合は、TextSearchOptions を使用して一致条件を制御します。
- setWholeWordsOnly は完全な単語への一致に限定します。
- setCaseSensitive は文字の大文字小文字の一致を要求するかどうかを制御します。
- setIncludeNotes はプレゼンテーションレベルの検索・置換・ハイライト操作にスライドノートを含めます。
正規表現操作は Java の Pattern を使用するため、ケースセンシティブや単語境界などの一致規則は式とフラグで定義されます。
テキストフレームの所有者の特定
汎用的なテキスト処理ワークフローでは、検索、置換、検証、エクスポート時に TextFrame が取得されることがよくあります。所有者を判定するには、TextFrame.getParentShape と TextFrame.getParentCell を使用します。
期待される戻り値は所有者の種類によって異なります。
| テキストフレームの所有者 | getParentShape |
getParentCell |
|---|---|---|
| テキストを保持する AutoShape などのシェイプ | 所有する Shape | None |
| テーブルセル | None |
所有する Cell |
両メソッドは読み取り専用のナビゲーションを提供し、呼び出してもテキストフレームは移動せず所有者も変更されません。汎用コードでは両方の値が None である可能性をチェックし、所有者が取得できない場合に備えて処理を行うべきです。
次の例は SlideUtil.getAllTextFrames を使用してプレゼンテーション内のテキストフレームを列挙します。シェイプの場合はシェイプ名、Java ランタイム型、所属スライドを報告し、テーブルセルの場合は 0 起点の列・行座標と所属スライドを報告します。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
SmartArt のコンテンツについては、SmartArtNode.getShapes でシェイプを列挙し、各シェイプの SmartArtShape.getTextFrame にアクセスします。テキストフレームは TextFrame.getParentShape で関連シェイプにたどり着き、TextFrame.getParentCell は None を返します。したがって、例のシェイプ分岐は SmartArt ノードからのテキストも処理します。
コールバックで一致情報を収集
jpype.JProxy を使用して IFindResultCallback を実装し、すべての一致に対して通知を受け取ります。foundResult メソッドは該当テキストフレーム、元テキスト、一致テキスト、位置情報を提供します。
コールバック自体はスライド番号を直接受け取らないため、下記実装では親スライドから番号を導出し、スライドノート内のテキストにも対応しています。オプションのスライド番号を設けることで、他のスライド種別に紐付くテキストにも同一の結果モデルを使用できます。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
置換操作の場合、found_text には元の一致テキストが含まれるため、コールバックは置換された正確な語句を記録できます。
テキストのハイライト
TextFrame.highlightText メソッドを使用して、テキストフレーム内のリテラルテキスト一致をハイライトします。検索条件は TextSearchOptions で制御し、コールバックで一致詳細を収集します。
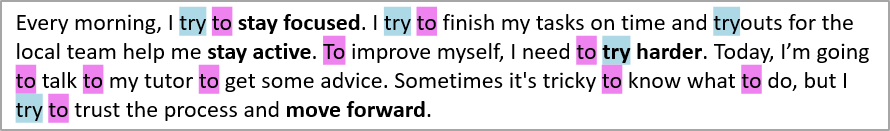
以下のコード例は文字列 “try” のすべての出現をハイライトし、続いて完全な単語 “to” のみをハイライトします。両検索とも同一コールバックに一致情報を送ります。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # テキストフレーム内の "try" のすべての出現箇所をハイライトする。
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # 完全な単語 "to" のみをハイライトする。
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
結果:
正規表現を使用したテキストのハイライト
TextFrame.highlightRegex メソッドは、正規表現で見つかったテキスト一致をハイライトします。
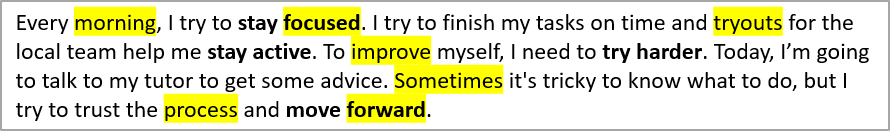
次のコードは 7 文字以上の単語すべてをハイライトし、各一致を収集します。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
結果:
プレゼンテーション全体のテキストハイライト
Presentation.highlightText と Presentation.highlightRegex を使用して、プレゼンテーション内のすべての該当テキストフレームを検索します。以下の例はリテラル語句とすべてのメールアドレスをハイライトし、2 つの検索結果を別々のコレクションに保持します。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
テキストフレーム内のテキスト置換
リテラルテキスト置換には TextFrame.replaceText、パターン置換には TextFrame.replaceRegex を使用します。これらのメソッドは既存のテキストフレーム内の一致部分だけを更新し、周囲の書式を保持したまま置換を行います。
次の例は綴りのバリエーションを統一し、続いてバージョンラベルを置換します。同一コールバックが両操作で一致した元語句を記録します。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
一致が異なる書式領域にまたがる場合は、置換後の書式が期待通りか確認してください。
プレゼンテーション全体のテキスト置換
Presentation.replaceText と Presentation.replaceRegex を使用して、プレゼンテーション全体に同じ操作を適用できます。テンプレートのクリーンアップ、用語の更新、情報削除に便利です。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
レポート作成のための一致グルーピング
すべての結果はスライド番号とテキストフレームを保持しているため、アプリケーションは監査やレポート、レビューのワークフロー向けに一致をグループ化できます。以下の例は、収集した結果をまずスライド単位で、次にテキストフレーム単位でグルーピングします。
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
よくある質問
テキストボックス 1 つだけを検索したい場合はどうすればよいですか?
対象シェイプのテキストフレームを取得し、そのテキストフレームに対して TextFrame.highlightText、TextFrame.highlightRegex、TextFrame.replaceText、または TextFrame.replaceRegex を呼び出します。プレゼンテーションレベルのメソッドはすべての該当テキストフレームを対象とします。
完全な単語かつ正しい大文字小文字で一致させるには?
TextSearchOptions.setWholeWordsOnly と TextSearchOptions.setCaseSensitive を True に設定し、リテラルテキストのハイライトまたは置換メソッドにオプションを渡します。正規表現の場合は、Java の Pattern 自体で単語境界とケースセンシティブを定義します。
検索・置換にスライドノートのテキストも含められますか?
はい。プレゼンテーションレベルのリテラルテキスト操作で TextSearchOptions.setIncludeNotes を True に設定します。上記のコールバック実装は、ノートスライド内の一致を親スライド番号にマッピングします。
プレゼンテーションを再度走査せずにレポートを作成する方法は?
ハイライトまたは置換操作に IFindResultCallback 実装を渡します。コールバックは操作実行中にすべての一致を受け取り、後でグルーピングやエクスポートできるように元テキスト、マッチテキスト、位置、テキストフレーム、導出したスライド番号を保存できます。
テキストを置換しても書式は保持されますか?
TextFrame.replaceText と TextFrame.replaceRegex は既存のテキストフレーム内で一致部分だけを置換し、周囲の書式を保持します。一致が異なる書式領域にまたがる場合は、置換結果の書式が期待通りか確認してください。