
جستجو و جایگزینی متن در ارائههای PowerPoint در پایتون از طریق جاوا
بررسی کلی
Aspose.Slides for Python via Java میتواند متن را در یک فریم متنی منفرد یا در سراسر یک ارائه جستجو، هایلایت و جایگزین کند. هر عملیات میتواند از طریق یک callback نتیجه، برنامه را از هر مطابقت مطلع سازد. این امکان را فراهم میکند که ارائه را بهروزرسانی کنید و همزمان یک ردپای حسابرسی شامل متن مطابقت یافته، زمینه، موقعیت، فریم متن و شماره اسلاید بسازید.
این قابلیتها برای بازبینی، حذف اطلاعات حساس، بررسی اصطلاحات، تمیزکاری قالب و گردشهای کار گزارشگیری خودکار مفید هستند.
در مثالهای اولیه زیر، از فایلی به نام “sample.pptx” استفاده میکنیم که یک جعبه متن تک در اسلاید اول دارد و شامل متن زیر است:
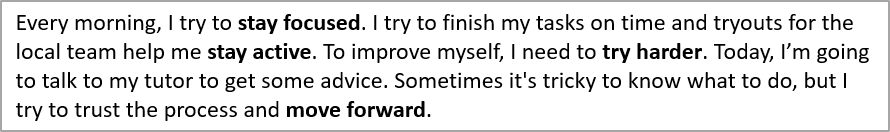
انتخاب محدوده جستجو
از متدهای موجود در TextFrame برای محدود کردن عملیات به یک فریم متنی استفاده کنید. از متدهای موجود در Presentation برای پردازش تمام متنهای قابل اعمال در ارائه بهره بگیرید.
| Operation | One text frame | Entire presentation |
|---|---|---|
| Highlight literal text | TextFrame.highlightText | Presentation.highlightText |
| Highlight regular-expression matches | TextFrame.highlightRegex | Presentation.highlightRegex |
| Replace literal text | TextFrame.replaceText | Presentation.replaceText |
| Replace regular-expression matches | TextFrame.replaceRegex | Presentation.replaceRegex |
پیکربندی تطبیق متن
برای عملیاتهای متن لغوی، از TextSearchOptions برای کنترل تطبیق استفاده کنید:
- setWholeWordsOnly تطبیقها را به کلمات کامل محدود میکند.
- setCaseSensitive تعیین میکند که آیا حساسیت به حروف بزرگ/کوچک باید رعایت شود.
- setIncludeNotes یادداشتهای اسلاید را در عملیاتهای جستجو، جایگزینی و هایلایت سطح ارائه شامل میشود.
عملیاتهای عبارات منظم از یک Pattern جاوا استفاده میکنند، بنابراین قوانینی مانند حساسیت به حروف و حدود کلمه توسط الگو و پرچمهای آن تعریف میشوند.
شناسایی مالک فریم متن
گردشکارهای عمومی پردازش متن اغلب یک TextFrame را در حین جستجو، جایگزینی، اعتبارسنجی یا استخراج دریافت میکنند. برای تعیین اینکه کدام شیء ارائه مالک فریم متن است، از TextFrame.getParentShape و TextFrame.getParentCell استفاده کنید.
مقادیری که انتظار میرود بسته به مالک متفاوت است:
| مالک فریم متن | getParentShape |
getParentCell |
|---|---|---|
| یک AutoShape یا شکل دیگری حاوی متن | شیء مالک Shape | None |
| یک سلول جدول | None |
شیء مالک Cell |
هر دو متد مسیریابی فقط‑خواندنی فراهم میکنند. فراخوانی آنها فریم متن را جابهجا یا مالک آن را تغییر نمیدهد. کد عمومی باید هر دو مقدار را برای None بررسی کرده و امکان عدم وجود هر دو مالک را مدیریت کند.
مثال زیر از SlideUtil.getAllTextFrames برای پیمایش فریمهای متن در یک ارائه استفاده میکند. برای اشکال، نام شکل، نوع زمان اجرا در جاوا و اسلاید حاوی آن را گزارش میدهد. برای سلولهای جدول، مختصات ستون و ردیف صفر‑مبنا و اسلاید حاوی آن را گزارش میکند.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
برای محتوای SmartArt، از اشکال موجود در SmartArtNode.getShapes عبور کنید و به هر SmartArtShape.getTextFrame دسترسی پیدا کنید. فریم متن میتواند از طریق TextFrame.getParentShape به شکل مرتبط خود ردیابی شود، در حالی که TextFrame.getParentCell None برمیگرداند. بنابراین شاخه شکل در مثال نیز متن موجود در گرههای SmartArt را مدیریت میکند.
جمعآوری اطلاعات مطابقت با Callback
IFindResultCallback را از طریق jpype.JProxy پیادهسازی کنید تا برای هر مطابقت یک اعلان دریافت کنید. متد foundResult آن فریم متن مرتبط، متن منبع، متن مطابقت یافته و موقعیت مطابقت را فراهم میکند.
Callback شماره اسلاید را مستقیماً دریافت نمیکند. پیادهسازی زیر آن را از اسلاید والد استخراج میکند و همچنین متن یافتشده در یادداشتهای اسلاید را مدیریت میکند. یک شماره اسلاید اختیاری به همان مدل نتیجه اجازه میدهد تا متن مربوط به انواع دیگر اسلایدها را نشان دهد.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
برای عملیاتهای جایگزینی، found_text شامل متن اصلی مطابقت یافته است، بنابراین callback میتواند دقیقاً ثبت کند که کدام اصطلاحات جایگزین شدهاند.
هایلایت متن
از متد TextFrame.highlightText برای هایلایت تطبیقهای متن لغوی در یک فریم متن استفاده کنید. برای کنترل جستجو، یک شیء TextSearchOptions را پاس کنید و برای جمعآوری جزئیات مطابقت یک callback فراهم کنید.
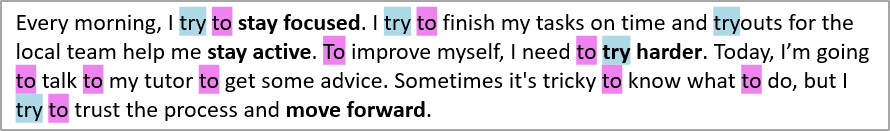
کد مثال زیر تمام وقوعهای کاراکترهای “try” را هایلایت میکند و سپس فقط کلمه کامل “to” را هایلایت مینماید. هر دو جستجو مطابقتهای خود را به همان callback گزارش میدهند.
import jpype
import asposeslides
if not jpype.isJVMStarted():
jpype.startJVM()
from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions
Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")
class TextMatch:
def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
self.text_frame = text_frame
self.source_text = source_text
self.found_text = found_text
self.text_position = text_position
self.slide_number = slide_number
class TextSearchCallback:
def __init__(self):
self.results = []
def foundResult(self, text_frame, source_text, found_text, text_position):
parent_shape = text_frame.getParentShape()
parent_cell = text_frame.getParentCell()
if parent_shape is not None:
parent_slide = parent_shape.getSlide()
elif parent_cell is not None:
parent_slide = parent_cell.getSlide()
else:
parent_slide = text_frame.getSlide()
slide_number = None
if isinstance(parent_slide, Slide):
slide_number = parent_slide.getSlideNumber()
elif isinstance(parent_slide, NotesSlide):
slide_number = parent_slide.getParentSlide().getSlideNumber()
result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
self.results.append(result)
presentation = Presentation("sample.pptx")
try:
slide = presentation.getSlides().get_Item(0)
shape = slide.getShapes().get_Item(0)
callback_handler = TextSearchCallback()
callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
substring_search_options = TextSearchOptions()
substring_search_options.setCaseSensitive(False)
substring_highlight_color = Color(173, 216, 230)
# برجستهسازی تمام دفعات وقوع "try" در فریم متن.
shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)
whole_word_search_options = TextSearchOptions()
whole_word_search_options.setWholeWordsOnly(True)
whole_word_search_options.setCaseSensitive(False)
whole_word_highlight_color = Color(238, 130, 238)
# برجستهسازی فقط کلمه کامل "to".
shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)
for result in callback_handler.results:
print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")
presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
presentation.dispose()
نتیجه:
هایلایت متن با استفاده از عبارات منظم
متد TextFrame.highlightRegex مطابقتهای متنی یافتشده توسط یک عبارت منظم را در یک فریم متن هایلایت میکند.
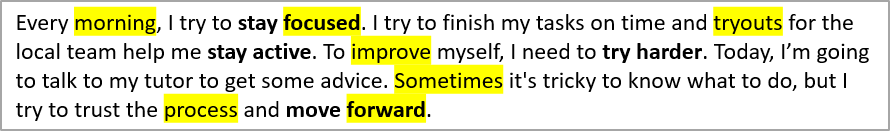
کد زیر تمام کلماتی که شامل هفت یا بیشتر حرف هستند را هایلایت میکند و هر مطابقت را جمعآوری مینماید:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
نتیجه:
هایلایت متن در سراسر یک ارائه
از متدهای Presentation.highlightText و Presentation.highlightRegex برای جستجوی تمام فریمهای متنی قابل اعمال در یک ارائه استفاده کنید. مثال زیر یک عبارت لغوی و تمام آدرسهای ایمیل را هایلایت میکند و برای دو جستجو مجموعههای نتیجه جداگانهای نگه میدارد.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
جایگزینی متن در یک فریم متن
از TextFrame.replaceText برای متن لغوی و از TextFrame.replaceRegex برای جایگزینی مبتنی بر الگو استفاده کنید. این متدها متن مطابقت یافته را داخل فریم متن موجود بهروزرسانی میکنند، بهطوری که قالببندی بخشهای اطراف حفظ میشود و نیازی به بازسازی فریم متن از یک رشته ساده نیست.
مثال زیر یک گونهٔ املایی را استاندارد میکند و سپس برچسبهای نسخه را جایگزین مینماید. همان callback اصطلاحات اصلی مطابقت یافته را توسط هر دو عملیات ثبت میکند.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
اگر یک مطابقت بخشهایی با قالببندی متفاوت را در بر داشته باشد، خروجی را بررسی کنید تا تعیین کنید کدام قالببندی باید برای متن جایگزین اعمال شود.
جایگزینی متن در سراسر یک ارائه
از Presentation.replaceText و Presentation.replaceRegex برای اعمال همان عملیاتها در تمام ارائه استفاده کنید. این کار برای تمیزکاری قالب، بهروزرسانی اصطلاحات و حذف اطلاعات حساس مفید است.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
گروهبندی مطابقتها برای گزارشگیری
از آنجا که هر نتیجه شماره اسلاید و فریم متن خود را ذخیره میکند، برنامهها میتوانند مطابقتها را برای حسابرسی، گزارشگیری یا گردشهای کار بازبینی گروهبندی کنند. مثال زیر نتایج جمعآوریشده را ابتدا بر اساس اسلاید و سپس بر اساس فریم متن گروهبندی میکند:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
پرسشهای متداول
چگونه میتوانم فقط یک جعبه متن را به جای کل ارائه جستجو کنم؟
فریم متن شکل را بهدست آورده و روی آن TextFrame.highlightText، TextFrame.highlightRegex، TextFrame.replaceText یا TextFrame.replaceRegex را فراخوانی کنید. متدهای سطح ارائه تمام فریمهای متن قابل اعمال را پردازش میکنند.
چگونه میتوانم کلمات کامل را با حروف بزرگ/کوچک صحیح مطابقت دهم؟
TextSearchOptions.setWholeWordsOnly و TextSearchOptions.setCaseSensitive را به True تنظیم کنید و گزینهها را به متدهای هایلایت یا جایگزینی متن لغوی پاس دهید. برای عبارات منظم، حدود کلمه و حساسیت به حروف را در خود Pattern جاوا تعریف کنید.
آیا میتوان جستجو و جایگزینی را شامل متن در یادداشتهای اسلاید کرد؟
بله. هنگام استفاده از عملیات متن لغوی سطح ارائه، TextSearchOptions.setIncludeNotes را به True تنظیم کنید. پیادهسازی callback نشاندادهشده در بالا مطابقت در اسلاید یادداشت را به شماره اسلاید والد آن بازمیگرداند.
چگونه میتوانم گزارش را بدون اسکن دوبارهٔ ارائه تهیه کنم؟
یک پیادهسازی IFindResultCallback را به عملیات هایلایت یا جایگزینی پاس کنید. callback در طول اجرا هر مطابقت را دریافت میکند، بنابراین برنامه میتواند متن منبع، متن مطابقت یافته، موقعیت، فریم متن و شماره اسلاید استخراجشده را برای گروهبندی یا خروجی بعدی ذخیره کند.
آیا جایگزینی متن قالببندی آن را حفظ میکند؟
TextFrame.replaceText و TextFrame.replaceRegex متن مطابقت یافته را درون فریم متن موجود تغییر میدهند و قالببندی بخشهای اطراف را حفظ میکنند. اگر یک مطابقت بخشهایی با قالببندی متفاوت را در بر داشته باشد، نتیجه را بررسی کنید تا اطمینان حاصل کنید جایگزینی از استایل دلخواه استفاده میکند.