
Rechercher et remplacer du texte dans les présentations PowerPoint avec Python via Java
Aperçu
Aspose.Slides for Python via Java peut rechercher, mettre en surbrillance et remplacer du texte dans un cadre de texte individuel ou dans l’ensemble d’une présentation. Chaque opération peut également notifier une application de chaque correspondance via un rappel de résultat. Cela permet de mettre à jour une présentation et de créer simultanément une trace d’audit contenant le texte correspondant, son contexte, sa position, le cadre de texte et le numéro de diapositive.
Ces fonctionnalités sont utiles pour la révision, la rédaction, les vérifications de terminologie, le nettoyage de modèles et les flux de travail de génération de rapports automatisés.
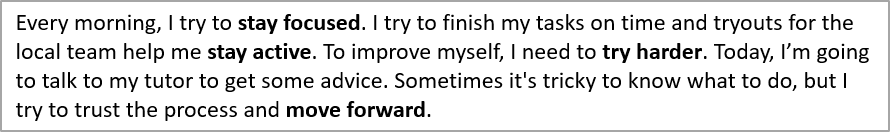
Dans les premiers exemples ci‑dessous, nous utilisons un fichier nommé “sample.pptx”, qui contient une seule zone de texte sur la première diapositive avec le texte suivant :
Choisir la portée de la recherche
Utilisez les méthodes de TextFrame pour limiter une opération à un seul cadre de texte. Utilisez les méthodes de Presentation pour traiter tout le texte applicable dans la présentation.
| Opération | Un seul cadre de texte | Toute la présentation |
|---|---|---|
| Mettre en surbrillance le texte littéral | TextFrame.highlightText | Presentation.highlightText |
| Mettre en surbrillance les correspondances d’expression régulière | TextFrame.highlightRegex | Presentation.highlightRegex |
| Remplacer le texte littéral | TextFrame.replaceText | Presentation.replaceText |
| Remplacer les correspondances d’expression régulière | TextFrame.replaceRegex | Presentation.replaceRegex |
Configurer la correspondance de texte
Pour les opérations de texte littéral, utilisez TextSearchOptions pour contrôler la correspondance :
- setWholeWordsOnly limite les correspondances aux mots complets.
- setCaseSensitive contrôle si la casse des caractères doit correspondre.
- setIncludeNotes inclut les notes de diapositives dans les opérations de recherche, de remplacement et de mise en surbrillance au niveau de la présentation.
Les opérations d’expression régulière utilisent un Pattern Java, de sorte que les règles de correspondance comme la sensibilité à la casse et les limites de mots sont définies par l’expression et ses indicateurs.
Identifier le propriétaire d’un cadre de texte
Les flux de travail génériques de traitement de texte reçoivent souvent un TextFrame lors de la recherche, du remplacement, de la validation ou de l’exportation de texte. Utilisez TextFrame.getParentShape et TextFrame.getParentCell pour déterminer quel objet de la présentation possède le cadre de texte.
Les valeurs attendues dépendent du propriétaire :
| Propriétaire du cadre de texte | getParentShape |
getParentCell |
|---|---|---|
| Une AutoShape ou une autre forme contenant du texte | La Shape propriétaire | None |
| Une cellule de tableau | None |
La Cell propriétaire |
Les deux méthodes offrent une navigation en lecture seule. Les appeler ne déplace pas le cadre de texte et ne change pas son propriétaire. Le code générique doit vérifier les deux valeurs pour None et gérer la possibilité qu’aucun propriétaire ne soit disponible.
L’exemple suivant utilise SlideUtil.getAllTextFrames pour parcourir les cadres de texte d’une présentation. Pour les formes, il indique le nom de la forme, le type d’exécution Java et la diapositive contenant. Pour les cellules de tableau, il indique les coordonnées de colonne et de ligne basées sur zéro ainsi que la diapositive contenant.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Pour le contenu SmartArt, parcourez les formes dans SmartArtNode.getShapes et accédez à chaque SmartArtShape.getTextFrame. Le cadre de texte peut être retracé à la forme associée via TextFrame.getParentShape, tandis que TextFrame.getParentCell renvoie None. Ainsi, la branche forme de l’exemple gère également le texte provenant des nœuds SmartArt.
Collecter les informations de correspondance avec un rappel
Implémentez IFindResultCallback via jpype.JProxy pour recevoir une notification pour chaque correspondance. Sa méthode foundResult fournit le cadre de texte concerné, le texte source, le texte correspondant et la position de la correspondance.
Le rappel ne reçoit pas directement le numéro de diapositive. L’implémentation ci‑dessous le déduit de la diapositive parente et gère également le texte trouvé dans les notes de diapositives. Un numéro de diapositive optionnel permet au même modèle de résultat de représenter du texte associé à d’autres types de diapositives.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Pour les opérations de remplacement, found_text contient le texte original correspondant, de sorte que le rappel puisse enregistrer exactement quels termes ont été remplacés.
Mettre en surbrillance du texte
Utilisez la méthode TextFrame.highlightText pour mettre en surbrillance les correspondances de texte littéral dans un cadre de texte. Passez TextSearchOptions pour contrôler la recherche et un rappel pour collecter les détails des correspondances.
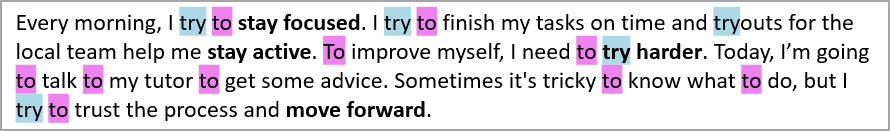
L’exemple de code ci‑dessous met en surbrillance toutes les occurrences des caractères “try” puis ne met en surbrillance que le mot complet “to”. Les deux recherches signalent leurs correspondances au même rappel.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Mettre en surbrillance chaque occurrence de "try" dans le cadre de texte.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Mettre en surbrillance uniquement le mot complet "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Le résultat :
Mettre en surbrillance du texte à l’aide d’expressions régulières
La méthode TextFrame.highlightRegex met en surbrillance les correspondances de texte trouvées par une expression régulière dans un cadre de texte.
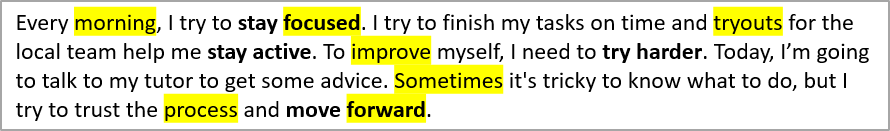
Le code suivant met en surbrillance tous les mots contenant sept caractères ou plus et collecte chaque correspondance :
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Le résultat :
Mettre en surbrillance du texte dans toute la présentation
Utilisez Presentation.highlightText et Presentation.highlightRegex pour rechercher tous les cadres de texte applicables dans une présentation. L’exemple suivant met en surbrillance un terme littéral et toutes les adresses e‑mail tout en conservant des collections de résultats séparées pour les deux recherches.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Remplacer du texte dans un cadre de texte
Utilisez TextFrame.replaceText pour le texte littéral et TextFrame.replaceRegex pour le remplacement basé sur un modèle. Ces méthodes mettent à jour le texte correspondant dans le cadre de texte existant, qui conserve le formatage de la partie environnante au lieu de reconstruire le cadre de texte à partir d’une chaîne brute.
L’exemple suivant normalise une variante d’orthographe puis remplace les libellés de version. Le même rappel enregistre les termes originaux correspondants aux deux opérations.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Si une correspondance couvre des parties avec des formats différents, examinez le résultat pour confirmer quel format doit s’appliquer au texte remplacé.
Remplacer du texte dans toute la présentation
Utilisez Presentation.replaceText et Presentation.replaceRegex pour appliquer les mêmes opérations à l’ensemble de la présentation. Cela est utile pour le nettoyage de modèles, les mises à jour de terminologie et la rédaction.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Regrouper les correspondances pour les rapports
Comme chaque résultat stocke son numéro de diapositive et son cadre de texte, les applications peuvent regrouper les correspondances pour l’audit, les rapports ou les flux de travail de révision. L’exemple suivant regroupe les résultats collectés d’abord par diapositive puis par cadre de texte :
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
Comment puis‑je rechercher uniquement une boîte de texte au lieu de toute la présentation ?
Obtenez le cadre de texte de la forme et appelez TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText ou TextFrame.replaceRegex sur ce cadre de texte. Les méthodes au niveau de la présentation traitent tous les cadres de texte applicables à la place.
Comment puis‑je faire correspondre des mots complets avec la bonne capitalisation ?
Définissez TextSearchOptions.setWholeWordsOnly et TextSearchOptions.setCaseSensitive sur True, puis transmettez les options à une méthode de mise en surbrillance ou de remplacement de texte littéral. Pour les expressions régulières, définissez les limites de mots et la sensibilité à la casse directement dans le Pattern Java.
La recherche et le remplacement peuvent‑ils inclure le texte des notes de diapositive ?
Oui. Définissez TextSearchOptions.setIncludeNotes sur True lors de l’utilisation d’une opération de texte littéral au niveau de la présentation. L’implémentation du rappel montrée ci‑dessus associe une correspondance dans une diapositive de notes à son numéro de diapositive parent.
Comment puis‑je créer un rapport sans analyser la présentation une seconde fois ?
Passez une implémentation IFindResultCallback à l’opération de mise en surbrillance ou de remplacement. Le rappel reçoit chaque correspondance pendant l’exécution de l’opération, ce qui permet à l’application de stocker le texte source, le texte correspondant, la position, le cadre de texte et le numéro de diapositive dérivé pour un regroupement ou une exportation ultérieure.
Le remplacement du texte conserve‑t‑il son formatage ?
TextFrame.replaceText et TextFrame.replaceRegex modifient le texte correspondant dans le cadre de texte existant et conservent le formatage de la partie environnante. Si une correspondance couvre des parties avec des formats différents, examinez le résultat pour vous assurer que le remplacement utilise le style souhaité.