
Szöveg keresése és helyettesítése PowerPoint előadásokban Python via Java
Áttekintés
Az Aspose.Slides for Python via Java képes keresni, kiemelni és helyettesíteni a szöveget egyetlen szövegkeretben vagy egy teljes bemutatóban. Minden művelet értesítheti az alkalmazást minden egyezésről egy eredmény‑visszahívás (callback) segítségével. Ez lehetővé teszi a bemutató frissítését és egyúttal egy audit‑napló építését, amely tartalmazza a megtalált szöveget, annak környezetét, pozícióját, szövegkeretét és a dia számát.
E képességek hasznosak felülvizsgálathoz, adatkitakarásra, terminológiai ellenőrzéshez, sablon-tisztításhoz és automatizált jelentési munkafolyamatokhoz.
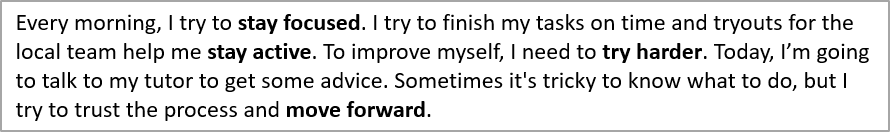
Az alábbi első példákban a „sample.pptx” nevű fájlt használjuk, amely az első dián egyetlen szövegdobozt tartalmaz a következő szöveggel:
Keresse ki a keresés hatókörét
Használja a TextFrame metódusait egy művelet korlátozásához egy szövegkeretre. Használja a Presentation metódusait a bemutatóban található összes alkalmazható szöveg feldolgozásához.
| Művelet | Egy szövegkeret | Teljes bemutató |
|---|---|---|
| Szöveg kiemelése (szöveges) | TextFrame.highlightText | Presentation.highlightText |
| Szabályos kifejezés egyezések kiemelése | TextFrame.highlightRegex | Presentation.highlightRegex |
| Szöveg helyettesítése (szöveges) | TextFrame.replaceText | Presentation.replaceText |
| Szabályos kifejezés egyezések helyettesítése | TextFrame.replaceRegex | Presentation.replaceRegex |
Szövegillesztés beállítása
Szöveges (literal) műveletekhez használja a TextSearchOptions osztályt az illesztés vezérléséhez:
- setWholeWordsOnly csak teljes szavakra korlátozza az egyezéseket.
- setCaseSensitive szabályozza, hogy a kis‑ és nagybetűknek egyezniük kell‑e.
- setIncludeNotes a diák jegyzeteit is belevonja a bemutató‑szintű keresésbe, helyettesítésbe és kiemelésbe.
A szabályos‑kifejezés műveletek Java Pattern‑t használnak, így a kis‑/nagybetű érzékenység és a szótárolások az általa definiált kifejezésben és jelzőiben vannak meghatározva.
A szövegkeret tulajdonosának meghatározása
Az általános szövegfeldolgozó munkafolyamatok gyakran kapnak egy TextFrame objektumot keresés, helyettesítés, érvényesítés vagy exportálás során. Használja a TextFrame.getParentShape és a TextFrame.getParentCell metódusokat annak meghatározásához, hogy melyik bemutató‑objektum birtokolja a szövegkeretet.
A várt értékek a tulajdonostól függnek:
| Szövegkeret tulajdonosa | getParentShape |
getParentCell |
|---|---|---|
| Egy AutoShape vagy más szöveget tartalmazó alakzat | A tulajdonos Shape | None |
| Egy táblázatcellá | None |
A tulajdonos Cell |
Mindkét metódus csak olvasási navigációt biztosít. Meghívásuk nem mozgatja a szövegkeretet, és nem változtatja meg a tulajdonost. Az általános kódnak mindkét értéket ellenőriznie kell None‑ra, és fel kell készülnie arra, hogy egyik tulajdonos sem áll rendelkezésre.
Az alábbi példa a SlideUtil.getAllTextFrames segítségével végigiterál a bemutató szövegkeretein. Alakzatok esetén kiírja az alakzat nevét, a Java futási típust és a tartalmazó diát. Táblázatcelláknál a nulla‑alapú oszlop‑ és sor‑koordinátákat, valamint a tartalmazó diát jelzi.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
A SmartArt tartalom esetén iteráljon a SmartArtNode.getShapes alakzatain, és érje el minden SmartArtShape.getTextFrame elemet. A szövegkeret a TextFrame.getParentShape segítségével visszakövethető a hozzátartozó alakzatra, míg a TextFrame.getParentCell None‑t ad vissza. Ezért a példában a forma ága a SmartArt‑node‑okból származó szöveget is kezeli.
Találati információk gyűjtése visszahívással
Implementálja az IFindResultCallback‑et a jpype.JProxy‑val, hogy minden egyezésről értesítést kapjon. A foundResult metódusa a kapcsolódó szövegkeretet, a forrásszöveget, a megtalált szöveget és a pozíciót adja vissza.
A visszahívás nem kap közvetlenül diaszámot. Az alábbi megvalósítás a szülő diából származtatja azt, és kezeli a diák jegyzeteiben talált szöveget is. Egy opcionális diaszám lehetővé teszi, hogy ugyanaz a eredménymodell más diatípusok szövegét is képviselje.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Helyettesítési műveleteknél a found_text az eredeti megtalált szöveget tartalmazza, így a visszahívás pontosan rögzítheti, mely kifejezéseket cserélték ki.
Szöveg kiemelése
Használja a TextFrame.highlightText metódust a szöveges egyezések kiemelésére egy szövegkeretben. Adja át a TextSearchOptions‑t a keresés vezérléséhez, és egy visszahívást a találatok részleteinek gyűjtéséhez.
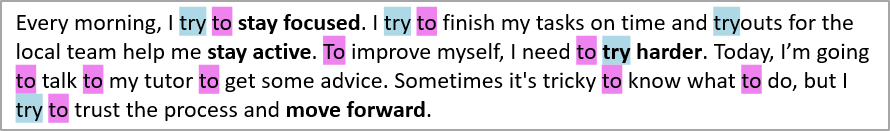
Az alábbi kódrészlet kiemeli az összes „try” karakter előfordulást, majd csak a teljes „to” szót. Mindkét keresés ugyanarra a visszahívásra jelenti az egyezéseket.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # A "try" minden előfordulásának kiemelése a szövegkeretben.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Csak a teljes "to" szót emeli ki.
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Az eredmény:
Szöveg kiemelése szabályos kifejezésekkel
A TextFrame.highlightRegex metódus kiemeli a szabályos kifejezéssel található szöveg egyezéseket egy szövegkeretben.
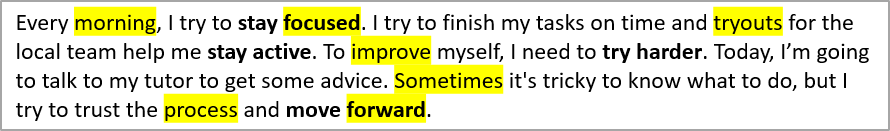
Az alábbi kód kiemeli az összes, legalább hét karaktert tartalmazó szót, és gyűjti az egyes egyezéseket:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Az eredmény:
Szöveg kiemelése a teljes bemutatóban
Használja a Presentation.highlightText és a Presentation.highlightRegex metódusokat a bemutató összes alkalmazható szövegkeretének kereséséhez. Az alábbi példa kiemel egy szó szerinti kifejezést és az összes e‑mail címet, miközben külön gyűjti az eredményeket a két kereséshez.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Szöveg helyettesítése egy szövegkeretben
Használja a TextFrame.replaceText metódust szöveges helyettesítéshez, illetve a TextFrame.replaceRegex metódust minta‑alapú helyettesítéshez. Ezek a metódusok a megtalált szöveget a meglévő szövegkereten belül frissítik, megtartva a környező rész formázását a tiszta karakterláncú újraépítés helyett.
Az alábbi példa egységesíti egy helyesírási variánst, majd cseréli a verziócímkéket. Az ugyanaz a visszahívás rögzíti az eredeti, mindkét művelet által megtalált kifejezéseket.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Ha egy egyezés több, különböző formázású részt fed le, ellenőrizze a kimenetet, hogy melyik formázás legyen alkalmazva a helyettesített szövegre.
Szöveg helyettesítése a teljes bemutatóban
Használja a Presentation.replaceText és a Presentation.replaceRegex metódusokat a bemutató egészére kiterjedő műveletekhez. Ez hasznos sablon‑tisztításhoz, terminológiai frissítésekhez és adatkitakaráshoz.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Találatok csoportosítása jelentéshez
Mivel minden eredmény tartalmazza a diaszámot és a szövegkeretet, az alkalmazások csoportosíthatják az egyezéseket audit, jelentés vagy felülvizsgálati munkafolyamatok céljából. Az alábbi példa először diánként, majd szövegkeretenként csoportosítja a gyűjtött eredményeket:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
GYIK
Hogyan kereshetek csak egy szövegdobozban a teljes bemutató helyett?
Szerezze meg az alakzat szövegkeretét, és hívja meg a TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText vagy TextFrame.replaceRegex metódust azon a szövegkereten. A bemutató‑szintű metódusok az összes alkalmazható szövegkeretet feldolgozzák.
Hogyan egyeztesse a teljes szavakat a megfelelő nagybetűkkel?
Állítsa a TextSearchOptions.setWholeWordsOnly és a TextSearchOptions.setCaseSensitive értékét True‑ra, és adja át a beállításokat a szöveges kiemelés vagy helyettesítés metódusának. Szabályos kifejezéseknél határozza meg a szóhatárokat és a kis‑/nagybetű érzékenységet a Java Pattern‑ben.
A keresés és helyettesítés magában foglalhatja a diák jegyzeteiben lévő szöveget?
Igen. Állítsa a TextSearchOptions.setIncludeNotes értékét True‑ra egy bemutató‑szintű szöveges művelet használatakor. A fent bemutatott visszahívás‑implementáció egy jegyzetdia‑egyezést visszakapcsol a szülő dia számához.
Hogyan készítsek jelentést anélkül, hogy a bemutatót újra beolvasnám?
Adjon át egy IFindResultCallback implementációt a kiemelés vagy helyettesítés műveletnek. A visszahívás minden egyezést megkap a művelet futása közben, így az alkalmazás tárolhatja a forrásszöveget, a megtalált szöveget, a pozíciót, a szövegkeretet és a származtatott diaszámot későbbi csoportosításhoz vagy exportáláshoz.
Megőrzi-e a szöveg helyettesítése annak formázását?
A TextFrame.replaceText és a TextFrame.replaceRegex módosítja a megtalált szöveget a meglévő szövegkereten belül, és megtartja a környező rész formázását. Ha egy egyezés több, különböző formázású részt fed le, ellenőrizze az eredményt, hogy a helyettesítés a kívánt stílus szerint történjen.