
Python via Java에서 PowerPoint 프레젠테이션의 텍스트 검색 및 교체
개요
Aspose.Slides for Python via Java은 개별 텍스트 프레임 또는 전체 프레젠테이션에서 텍스트를 검색, 강조 및 교체할 수 있습니다. 각 작업은 결과 콜백을 통해 모든 일치 항목에 대해 애플리케이션에 알릴 수 있습니다. 이를 통해 프레젠테이션을 업데이트하면서 일치된 텍스트, 해당 컨텍스트, 위치, 텍스트 프레임 및 슬라이드 번호를 포함하는 감사 로그를 동시에 생성할 수 있습니다.
이러한 기능은 검토, 삭제, 용어 확인, 템플릿 정리 및 자동 보고 워크플로에 유용합니다.
아래 첫 번째 예제에서는 첫 번째 슬라이드에 단일 텍스트 상자가 포함된 “sample.pptx” 파일을 사용합니다. 해당 텍스트는 다음과 같습니다:
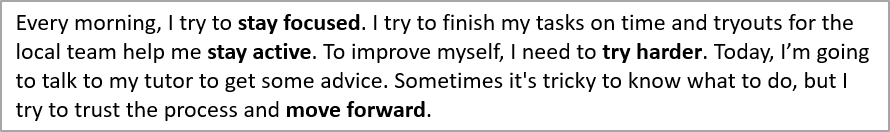
검색 범위 선택
TextFrame 메서드를 사용하여 작업을 하나의 텍스트 프레임으로 제한합니다. Presentation 메서드를 사용하여 프레젠테이션의 모든 적용 가능한 텍스트를 처리합니다.
| 작업 | 단일 텍스트 프레임 | 전체 프레젠테이션 |
|---|---|---|
| 리터럴 텍스트 강조 | TextFrame.highlightText | Presentation.highlightText |
| 정규식 일치 항목 강조 | TextFrame.highlightRegex | Presentation.highlightRegex |
| 리터럴 텍스트 교체 | TextFrame.replaceText | Presentation.replaceText |
| 정규식 일치 항목 교체 | TextFrame.replaceRegex | Presentation.replaceRegex |
텍스트 매칭 구성
리터럴 텍스트 작업의 경우, 일치를 제어하기 위해 TextSearchOptions을 사용합니다:
- setWholeWordsOnly 는 일치를 전체 단어로 제한합니다.
- setCaseSensitive 는 문자 대소문자를 일치시켜야 하는지를 제어합니다.
- setIncludeNotes 는 프레젠테이션 수준 검색, 교체 및 강조 작업에 슬라이드 노트를 포함합니다.
정규식 작업은 Java Pattern을 사용하므로 대소문자 구분 및 단어 경계와 같은 일치 규칙은 표현식 및 해당 플래그에 의해 정의됩니다.
텍스트 프레임 소유자 식별
일반 텍스트 처리 워크플로는 검색, 교체, 검증 또는 텍스트 내보내기 중에 종종 TextFrame을 받습니다. 해당 텍스트 프레임의 소유 프레젠테이션 객체를 확인하려면 TextFrame.getParentShape 및 TextFrame.getParentCell 를 사용합니다.
예상 값은 소유자에 따라 다릅니다:
| 텍스트 프레임 소유자 | getParentShape |
getParentCell |
|---|---|---|
| AutoShape 또는 다른 텍스트 포함 형태 | The owning Shape | None |
| 표 셀 | None |
The owning Cell |
두 메서드는 읽기 전용 탐색을 제공합니다. 호출해도 텍스트 프레임이 이동하거나 소유자가 변경되지 않습니다. 일반 코드는 두 값을 모두 None인지 확인하고 어느 소유자도 없을 가능성을 처리해야 합니다.
다음 예제는 SlideUtil.getAllTextFrames 를 사용하여 프레젠테이션의 텍스트 프레임을 순회합니다. 도형의 경우 도형 이름, Java 런타임 타입 및 포함 슬라이드를 보고합니다. 표 셀의 경우 0 기반 열 및 행 좌표와 포함 슬라이드를 보고합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
SmartArt 콘텐츠의 경우 SmartArtNode.getShapes 에서 도형을 순회하고 각 SmartArtShape.getTextFrame 에 접근합니다. 텍스트 프레임은 TextFrame.getParentShape 를 통해 연결된 도형으로 추적될 수 있으며, TextFrame.getParentCell 은 None을 반환합니다. 따라서 예제의 도형 분기는 SmartArt 노드의 텍스트도 처리합니다.
콜백을 사용한 일치 정보 수집
jpype.JProxy 를 통해 IFindResultCallback 을 구현하여 각 일치 항목에 대한 알림을 받을 수 있습니다. 해당 foundResult 메서드는 관련 텍스트 프레임, 원본 텍스트, 일치한 텍스트 및 일치 위치를 제공합니다.
콜백은 슬라이드 번호를 직접 받지 않습니다. 아래 구현은 부모 슬라이드에서 번호를 유도하고 슬라이드 노트에서 찾은 텍스트도 처리합니다. 선택적 슬라이드 번호를 사용하면 동일한 결과 모델이 다른 슬라이드 유형과 연결된 텍스트를 표현할 수 있습니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
교체 작업의 경우 found_text 에 원본 일치 텍스트가 포함되므로 콜백은 정확히 어느 용어가 교체되었는지 기록할 수 있습니다.
텍스트 강조
TextFrame.highlightText 메서드를 사용하여 텍스트 프레임 내 리터럴 텍스트 일치를 강조합니다. 검색을 제어하려면 TextSearchOptions 를 전달하고, 일치 세부 정보를 수집하려면 콜백을 전달합니다.
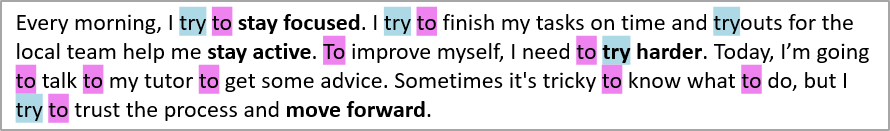
아래 코드 예제는 문자열 “try” 의 모든 발생을 강조한 다음 전체 단어 “to” 만 강조합니다. 두 검색 모두 동일한 콜백에 일치를 보고합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # 텍스트 프레임에서 "try"의 모든 발생을 강조합니다.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # 전체 단어 "to"만 강조합니다.
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
결과:
정규식을 사용한 텍스트 강조
TextFrame.highlightRegex 메서드는 정규식으로 찾은 텍스트 일치를 텍스트 프레임에서 강조합니다.
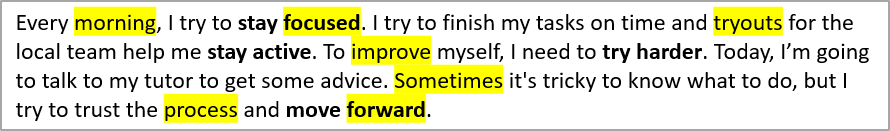
다음 코드는 7자 이상인 모든 단어를 강조하고 각 일치를 수집합니다:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
결과:
프레젠테이션 전체 텍스트 강조
Presentation.highlightText 와 Presentation.highlightRegex 를 사용하여 프레젠테이션의 모든 적용 가능한 텍스트 프레임을 검색합니다. 아래 예제는 리터럴 용어와 모든 이메일 주소를 강조하면서 두 검색에 대한 결과 수집을 별도로 유지합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
텍스트 프레임 내 텍스트 교체
리터럴 텍스트 교체에는 TextFrame.replaceText 를, 패턴 기반 교체에는 TextFrame.replaceRegex 를 사용합니다. 이 메서드들은 기존 텍스트 프레임 내 일치 텍스트를 업데이트하므로 주변 서식은 유지되고 문자열을 새로 만들지는 않습니다.
다음 예제는 철자 변형을 표준화한 뒤 버전 라벨을 교체합니다. 동일한 콜백이 두 작업에서 일치된 원본 용어를 기록합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
하나의 일치가 서로 다른 서식이 적용된 구간을 포함하는 경우, 교체 텍스트에 적용될 서식을 확인하기 위해 출력 결과를 검토하십시오.
프레젠테이션 전체 텍스트 교체
Presentation.replaceText 와 Presentation.replaceRegex 를 사용하여 프레젠테이션 전체에 동일한 작업을 적용합니다. 템플릿 정리, 용어 업데이트 및 삭제에 유용합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
보고를 위한 일치 그룹화
각 결과가 슬라이드 번호와 텍스트 프레임을 저장하므로, 애플리케이션은 감사, 보고 또는 검토 워크플로를 위해 일치를 그룹화할 수 있습니다. 아래 예제는 수집된 결과를 먼저 슬라이드별, 다음 텍스트 프레임별로 그룹화합니다.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
FAQ
전체 프레젠테이션이 아니라 하나의 텍스트 상자만 검색하려면 어떻게 해야 하나요?
해당 쉐이프의 텍스트 프레임을 가져와서 TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText 또는 TextFrame.replaceRegex 를 해당 텍스트 프레임에 호출합니다. 프레젠테이션 수준 메서드는 모든 적용 가능한 텍스트 프레임을 처리합니다.
전체 단어를 정확한 대소문자로 일치시키려면 어떻게 해야 하나요?
TextSearchOptions.setWholeWordsOnly 와 TextSearchOptions.setCaseSensitive 를 True 로 설정하고 옵션을 리터럴 텍스트 강조 또는 교체 메서드에 전달합니다. 정규식의 경우 Java Pattern 자체에 단어 경계와 대소문자 구분을 정의합니다.
검색 및 교체가 슬라이드 노트의 텍스트까지 포함할 수 있나요?
예. 프레젠테이션 수준 리터럴 텍스트 작업을 사용할 때 TextSearchOptions.setIncludeNotes 를 True 로 설정합니다. 위에 표시된 콜백 구현은 노트 슬라이드에서 일치를 찾아 해당 부모 슬라이드 번호로 매핑합니다.
프레젠테이션을 두 번째로 스캔하지 않고 보고서를 만들려면 어떻게 해야 하나요?
강조 또는 교체 작업에 IFindResultCallback 구현을 전달합니다. 콜백은 작업이 실행되는 동안 모든 일치를 받으므로 애플리케이션은 원본 텍스트, 일치 텍스트, 위치, 텍스트 프레임 및 파생된 슬라이드 번호를 저장해 나중에 그룹화하거나 내보낼 수 있습니다.
텍스트 교체가 서식을 유지합니까?
TextFrame.replaceText 와 TextFrame.replaceRegex 는 기존 텍스트 프레임 내 일치 텍스트를 수정하고 주변 서식을 유지합니다. 일치가 서로 다른 서식이 적용된 구간을 포함하는 경우, 교체 텍스트가 원하는 스타일을 사용하는지 결과를 확인하십시오.