
Buscar y reemplazar texto en presentaciones de PowerPoint en Python mediante Java
Descripción general
Aspose.Slides for Python via Java puede buscar, resaltar y reemplazar texto en un marco de texto individual o en toda una presentación. Cada operación también puede notificar a una aplicación sobre cada coincidencia mediante una devolución de llamada de resultados. Esto permite actualizar una presentación y, simultáneamente, crear una traza de auditoría que contenga el texto coincidente, su contexto, posición, marco de texto y número de diapositiva.
Estas capacidades son útiles para la revisión, la censura, la verificación de terminología, la limpieza de plantillas y los flujos de trabajo de generación de informes automatizados.
En los primeros ejemplos a continuación, utilizamos un archivo llamado “sample.pptx”, que contiene un único cuadro de texto en la primera diapositiva con el siguiente texto:
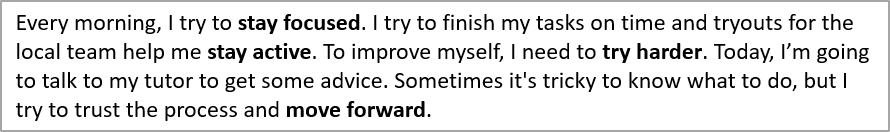
Elegir el ámbito de búsqueda
Utilice los métodos de TextFrame para limitar una operación a un marco de texto. Utilice los métodos de Presentation para procesar todo el texto aplicable en la presentación.
| Operación | Un marco de texto | Presentación completa |
|---|---|---|
| Resaltar texto literal | TextFrame.highlightText | Presentation.highlightText |
| Resaltar coincidencias de expresiones regulares | TextFrame.highlightRegex | Presentation.highlightRegex |
| Reemplazar texto literal | TextFrame.replaceText | Presentation.replaceText |
| Reemplazar coincidencias de expresiones regulares | TextFrame.replaceRegex | Presentation.replaceRegex |
Configurar la coincidencia de texto
Para operaciones de texto literal, utilice TextSearchOptions para controlar la coincidencia:
- setWholeWordsOnly limita las coincidencias a palabras completas.
- setCaseSensitive controla si se debe respetar la capitalización de los caracteres.
- setIncludeNotes incluye las notas de la diapositiva en las operaciones de búsqueda, reemplazo y resaltado a nivel de presentación.
Las operaciones basadas en expresiones regulares utilizan un Pattern de Java, por lo que reglas como la sensibilidad a mayúsculas y los límites de palabras se definen en la expresión y sus banderas.
Identificar el propietario de un marco de texto
Los flujos de trabajo genéricos de procesamiento de texto suelen recibir un TextFrame mientras buscan, reemplazan, validan o exportan texto. Utilice TextFrame.getParentShape y TextFrame.getParentCell para determinar qué objeto de la presentación posee el marco de texto.
Los valores esperados dependen del propietario:
| Propietario del marco de texto | getParentShape |
getParentCell |
|---|---|---|
| Una AutoShape u otra forma que contenga texto | La Shape propietaria | None |
| Una celda de tabla | None |
La Cell propietaria |
Ambos métodos proporcionan navegación solo de lectura. Llamarlos no mueve el marco de texto ni cambia su propietario. El código genérico debe comprobar ambos valores para None y gestionar la posibilidad de que ninguno de los propietarios esté disponible.
El siguiente ejemplo utiliza SlideUtil.getAllTextFrames para iterar a través de los marcos de texto de una presentación. Para formas, informa el nombre de la forma, el tipo de tiempo de ejecución de Java y la diapositiva contenedora. Para celdas de tabla, informa las coordenadas de columna y fila basadas en cero y la diapositiva contenedora.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

presentation = Presentation("presentation.pptx")
try:
    text_frames = SlideUtil.getAllTextFrames(presentation, False)
    for text_frame in text_frames:
        owner_shape = text_frame.getParentShape()
        owner_cell = text_frame.getParentCell()
        if owner_shape is not None:
            shape_name = str(owner_shape.getName()) or "(unnamed)"
            shape_type = owner_shape.getClass().getSimpleName()
            base_slide = owner_shape.getSlide()
        elif owner_cell is not None:
            base_slide = owner_cell.getSlide()
        else:
            print("The text frame owner is not available as a shape or table cell.")
            continue

        if isinstance(base_slide, Slide):
            slide_label = f"slide {base_slide.getSlideNumber()}"
        elif isinstance(base_slide, NotesSlide):
            slide_label = f"notes for slide {base_slide.getParentSlide().getSlideNumber()}"
        else:
            slide_label = str(base_slide.getClass().getSimpleName())

        if owner_shape is not None:
            print(f"Shape: {shape_name}; type: {shape_type}; {slide_label}")
        else:
            print(f"Table cell: column {owner_cell.getFirstColumnIndex()}, row {owner_cell.getFirstRowIndex()}; {slide_label}")
finally:
    presentation.dispose()
Para contenido de SmartArt, itere a través de las formas en SmartArtNode.getShapes y acceda a cada SmartArtShape.getTextFrame. El marco de texto puede rastrearse a su forma asociada mediante TextFrame.getParentShape, mientras que TextFrame.getParentCell devuelve None. Por lo tanto, la rama de forma en el ejemplo también maneja texto de nodos SmartArt.
Recopilar información de coincidencias con una devolución de llamada
Implemente IFindResultCallback mediante jpype.JProxy para recibir una notificación por cada coincidencia. Su método foundResult proporciona el marco de texto relacionado, el texto fuente, el texto coincidente y la posición de la coincidencia.
La devolución de llamada no recibe directamente un número de diapositiva. La implementación a continuación lo deriva de la diapositiva padre y también maneja texto encontrado en notas de diapositiva. Un número de diapositiva opcional permite que el mismo modelo de resultados represente texto asociado a otros tipos de diapositiva.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)
Para operaciones de reemplazo, found_text contiene el texto original coincidente, de modo que la devolución de llamada puede registrar exactamente qué términos fueron reemplazados.
Resaltar texto
Utilice el método TextFrame.highlightText para resaltar coincidencias de texto literal en un marco de texto. Pase TextSearchOptions para controlar la búsqueda y una devolución de llamada para recopilar los detalles de coincidencia.
El ejemplo de código a continuación resalta todas las ocurrencias de los caracteres “try” y luego resalta solo la palabra completa “to”. Ambas búsquedas informan sus coincidencias a la misma devolución de llamada.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)

    substring_search_options = TextSearchOptions()
    substring_search_options.setCaseSensitive(False)
    substring_highlight_color = Color(173, 216, 230)

    # Resaltar cada aparición de "try" en el marco de texto.
    shape.getTextFrame().highlightText("try", substring_highlight_color, substring_search_options, callback)

    whole_word_search_options = TextSearchOptions()
    whole_word_search_options.setWholeWordsOnly(True)
    whole_word_search_options.setCaseSensitive(False)
    whole_word_highlight_color = Color(238, 130, 238)

    # Resaltar solo la palabra completa "to".
    shape.getTextFrame().highlightText("to", whole_word_highlight_color, whole_word_search_options, callback)

    for result in callback_handler.results:
        print(f"Found '{result.found_text}' at position {result.text_position} on slide {result.slide_number}.")

    presentation.save("highlighted_text.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
El resultado:
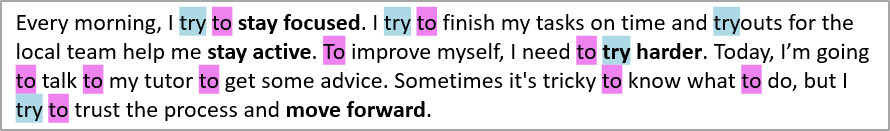
Resaltar texto mediante expresiones regulares
El método TextFrame.highlightRegex resalta coincidencias de texto encontradas mediante una expresión regular en un marco de texto.
El siguiente código resalta todas las palabras que contienen siete o más caracteres y recopila cada coincidencia:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("sample.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    regex = Pattern.compile("\\b[^\\s]{7,}\\b")

    shape.getTextFrame().highlightRegex(regex, Color.YELLOW, callback)

    presentation.save("highlighted_text_using_regex.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
El resultado:
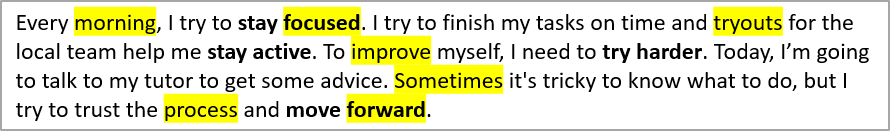
Resaltar texto en toda la presentación
Utilice Presentation.highlightText y Presentation.highlightRegex para buscar en todos los marcos de texto aplicables de una presentación. El siguiente ejemplo resalta un término literal y todas las direcciones de correo electrónico manteniendo colecciones de resultados separadas para ambas búsquedas.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    term_callback_handler = TextSearchCallback()
    term_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=term_callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    presentation.highlightText("confidential", Color.ORANGE, search_options, term_callback)

    email_callback_handler = TextSearchCallback()
    email_callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=email_callback_handler)
    email_regex = Pattern.compile("\\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\\.[A-Z]{2,}\\b", Pattern.CASE_INSENSITIVE)

    presentation.highlightRegex(email_regex, Color.YELLOW, email_callback)
    presentation.save("highlighted_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Reemplazar texto en un marco de texto
Utilice TextFrame.replaceText para texto literal y TextFrame.replaceRegex para reemplazo basado en patrones. Estos métodos actualizan el texto coincidente dentro del marco de texto existente, que conserva el formato de las porciones circundantes en lugar de reconstruir el marco de texto a partir de una cadena simple.
El siguiente ejemplo normaliza una variante ortográfica y luego reemplaza etiquetas de versión. La misma devolución de llamada registra los términos originales coincidentes en ambas operaciones.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    slide = presentation.getSlides().get_Item(0)
    shape = slide.getShapes().get_Item(0)
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(False)

    shape.getTextFrame().replaceText("colour", "color", search_options, callback)

    version_regex = Pattern.compile("\\bv\\d+(?:\\.\\d+)*\\b", Pattern.CASE_INSENSITIVE)
    shape.getTextFrame().replaceRegex(version_regex, "current version", callback)

    presentation.save("updated_text_frame.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Si una coincidencia abarca porciones con formato diferente, revise el resultado para confirmar qué formato debe aplicarse al texto de reemplazo.
Reemplazar texto en toda la presentación
Utilice Presentation.replaceText y Presentation.replaceRegex para aplicar las mismas operaciones en toda la presentación. Esto es útil para la limpieza de plantillas, actualizaciones de terminología y censura.
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
finally:
    presentation.dispose()
Agrupar coincidencias para informes
Dado que cada resultado almacena su número de diapositiva y marco de texto, las aplicaciones pueden agrupar coincidencias para auditorías, informes o flujos de revisión. El siguiente ejemplo agrupa los resultados recopilados primero por diapositiva y luego por marco de texto:
import jpype
import asposeslides

if not jpype.isJVMStarted():
    jpype.startJVM()

from asposeslides.api import Presentation, SaveFormat, Slide, NotesSlide, SlideUtil, TextSearchOptions

Color = jpype.JClass("java.awt.Color")
Pattern = jpype.JClass("java.util.regex.Pattern")

class TextMatch:
    def __init__(self, text_frame, source_text, found_text, text_position, slide_number):
        self.text_frame = text_frame
        self.source_text = source_text
        self.found_text = found_text
        self.text_position = text_position
        self.slide_number = slide_number


class TextSearchCallback:
    def __init__(self):
        self.results = []

    def foundResult(self, text_frame, source_text, found_text, text_position):
        parent_shape = text_frame.getParentShape()
        parent_cell = text_frame.getParentCell()
        if parent_shape is not None:
            parent_slide = parent_shape.getSlide()
        elif parent_cell is not None:
            parent_slide = parent_cell.getSlide()
        else:
            parent_slide = text_frame.getSlide()

        slide_number = None
        if isinstance(parent_slide, Slide):
            slide_number = parent_slide.getSlideNumber()
        elif isinstance(parent_slide, NotesSlide):
            slide_number = parent_slide.getParentSlide().getSlideNumber()

        result = TextMatch(text_frame, str(source_text), str(found_text), text_position, slide_number)
        self.results.append(result)


presentation = Presentation("presentation.pptx")
try:
    callback_handler = TextSearchCallback()
    callback = jpype.JProxy("com.aspose.slides.IFindResultCallback", inst=callback_handler)
    search_options = TextSearchOptions()
    search_options.setWholeWordsOnly(True)
    search_options.setCaseSensitive(True)

    presentation.replaceText("Contoso", "Example Corp", search_options, callback)

    account_number_regex = Pattern.compile("\\bACCT-\\d{6}\\b")
    presentation.replaceRegex(account_number_regex, "ACCT-REDACTED", callback)

    presentation.save("updated_presentation.pptx", SaveFormat.Pptx)
    matches_by_slide = {}
    for result in callback_handler.results:
        matches_by_text_frame = matches_by_slide.setdefault(result.slide_number, {})
        text_frame_matches = matches_by_text_frame.setdefault(result.text_frame, [])
        text_frame_matches.append(result)

    for slide_number, matches_by_text_frame in matches_by_slide.items():
        slide_label = "Other" if slide_number is None else str(slide_number)
        print(f"Slide: {slide_label}")
        for text_frame, results in matches_by_text_frame.items():
            print(f"  Text frame: {text_frame.getText()}")
            for result in results:
                print(f"    '{result.found_text}' at position {result.text_position}; context: '{result.source_text}'")
finally:
    presentation.dispose()
Preguntas frecuentes
¿Cómo puedo buscar solo en un cuadro de texto en lugar de en toda la presentación?
Obtenga el marco de texto de la forma y llame a TextFrame.highlightText, TextFrame.highlightRegex, TextFrame.replaceText o TextFrame.replaceRegex sobre ese marco de texto. Los métodos a nivel de presentación procesan todos los marcos de texto aplicables en su lugar.
¿Cómo puedo coincidir palabras completas con la capitalización correcta?
Configure TextSearchOptions.setWholeWordsOnly y TextSearchOptions.setCaseSensitive a True, y pase las opciones a un método de resaltado o reemplazo de texto literal. Para expresiones regulares, defina los límites de palabra y la sensibilidad a mayúsculas en el propio Pattern de Java.
¿Puede la búsqueda y el reemplazo incluir texto en las notas de la diapositiva?
Sí. Establezca TextSearchOptions.setIncludeNotes a True al utilizar una operación de texto literal a nivel de presentación. La implementación de la devolución de llamada mostrada arriba asigna una coincidencia en una diapositiva de notas a su número de diapositiva padre.
¿Cómo puedo crear un informe sin escanear la presentación una segunda vez?
Pase una implementación de IFindResultCallback a la operación de resaltado o reemplazo. La devolución de llamada recibe cada coincidencia mientras se ejecuta la operación, de modo que la aplicación puede almacenar el texto fuente, el texto coincidido, la posición, el marco de texto y el número de diapositiva derivado para su posterior agrupación o exportación.
¿El reemplazo de texto preserva su formato?
TextFrame.replaceText y TextFrame.replaceRegex modifican el texto coincidente dentro del marco de texto existente y conservan el formato de las porciones circundantes. Si una coincidencia abarca porciones con formato diferente, inspeccione el resultado para asegurarse de que el reemplazo utilice el estilo deseado.